使用 puppeteer 批量生成微信读书 423 活动勋章
背景
众所周知,每年 4 月 23 日是世界读书日,微信读书这次又搞活动了,要给每个用户生成一个独特的勋章。
这个勋章有多独特呢?勋章上面会有两个数字,左上角的数字代表用户注册微信读书到现在的总年数,右下角的数字代表用户这些年来总共读过多少本书。
例如我注册了 8 年,读过 230 本书,勋章就是下面这个样子👇(惭愧,没怎么好好读书
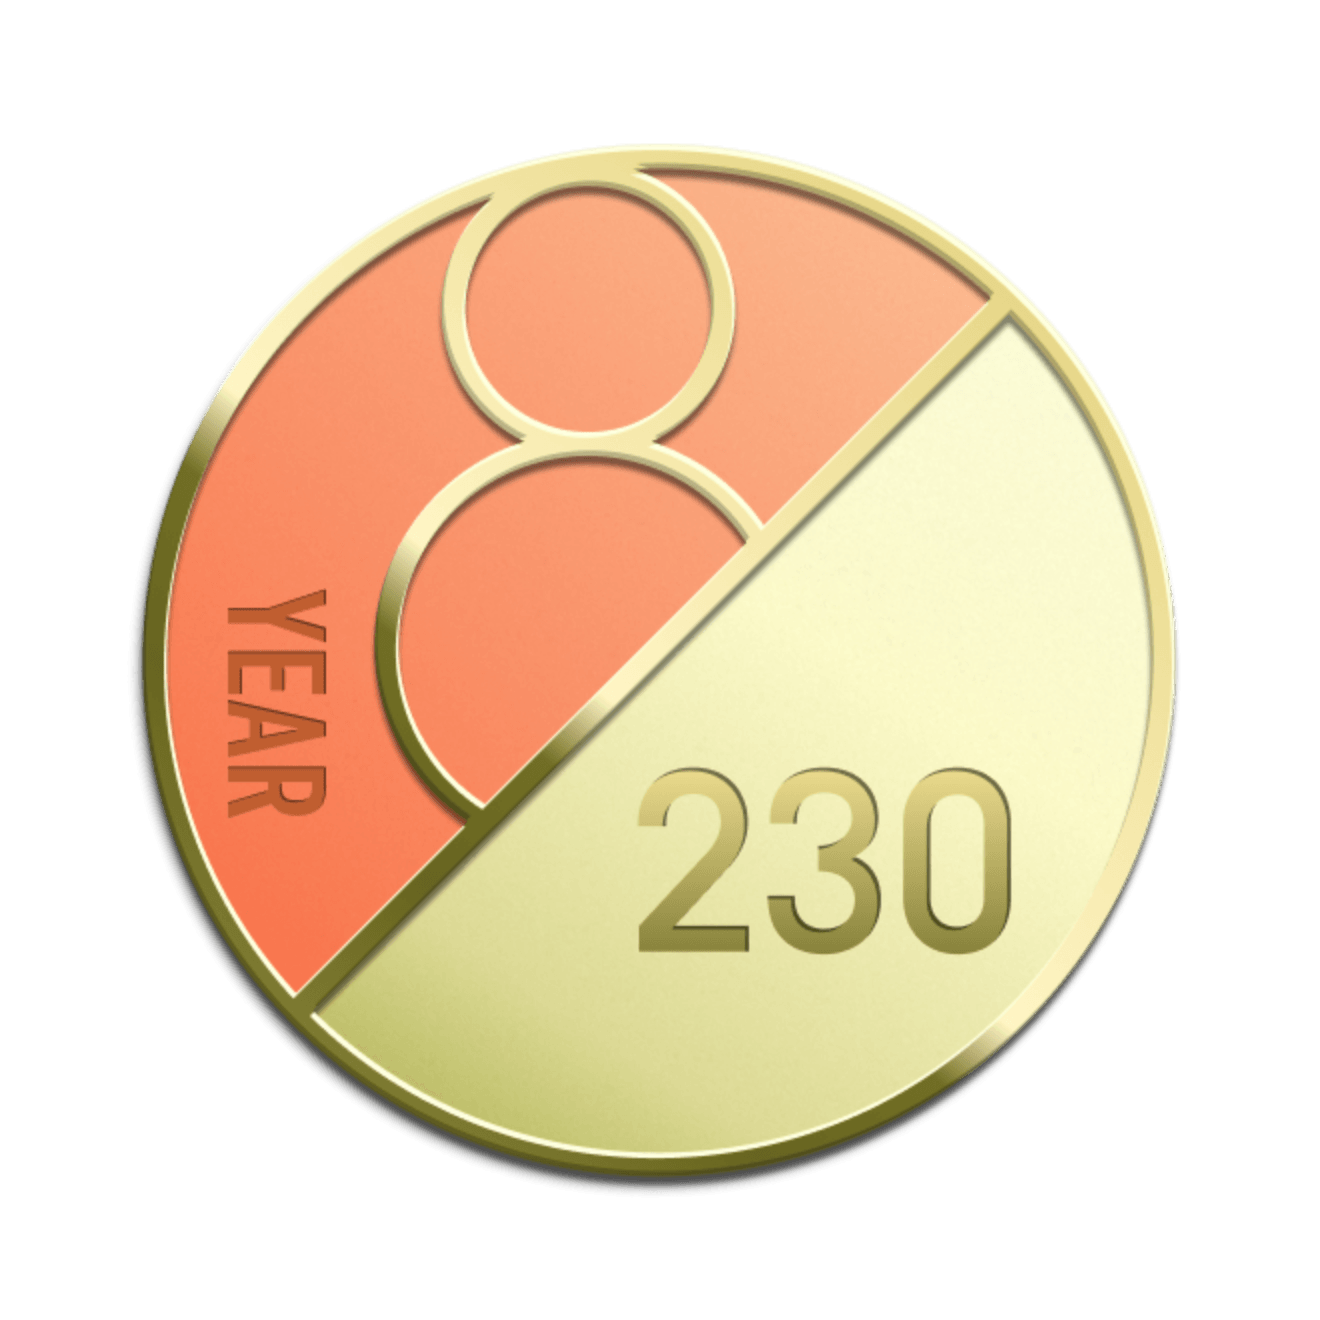
微信读书 App 上架至今总共 10 年,所以左上角数字的范围是 1~10。
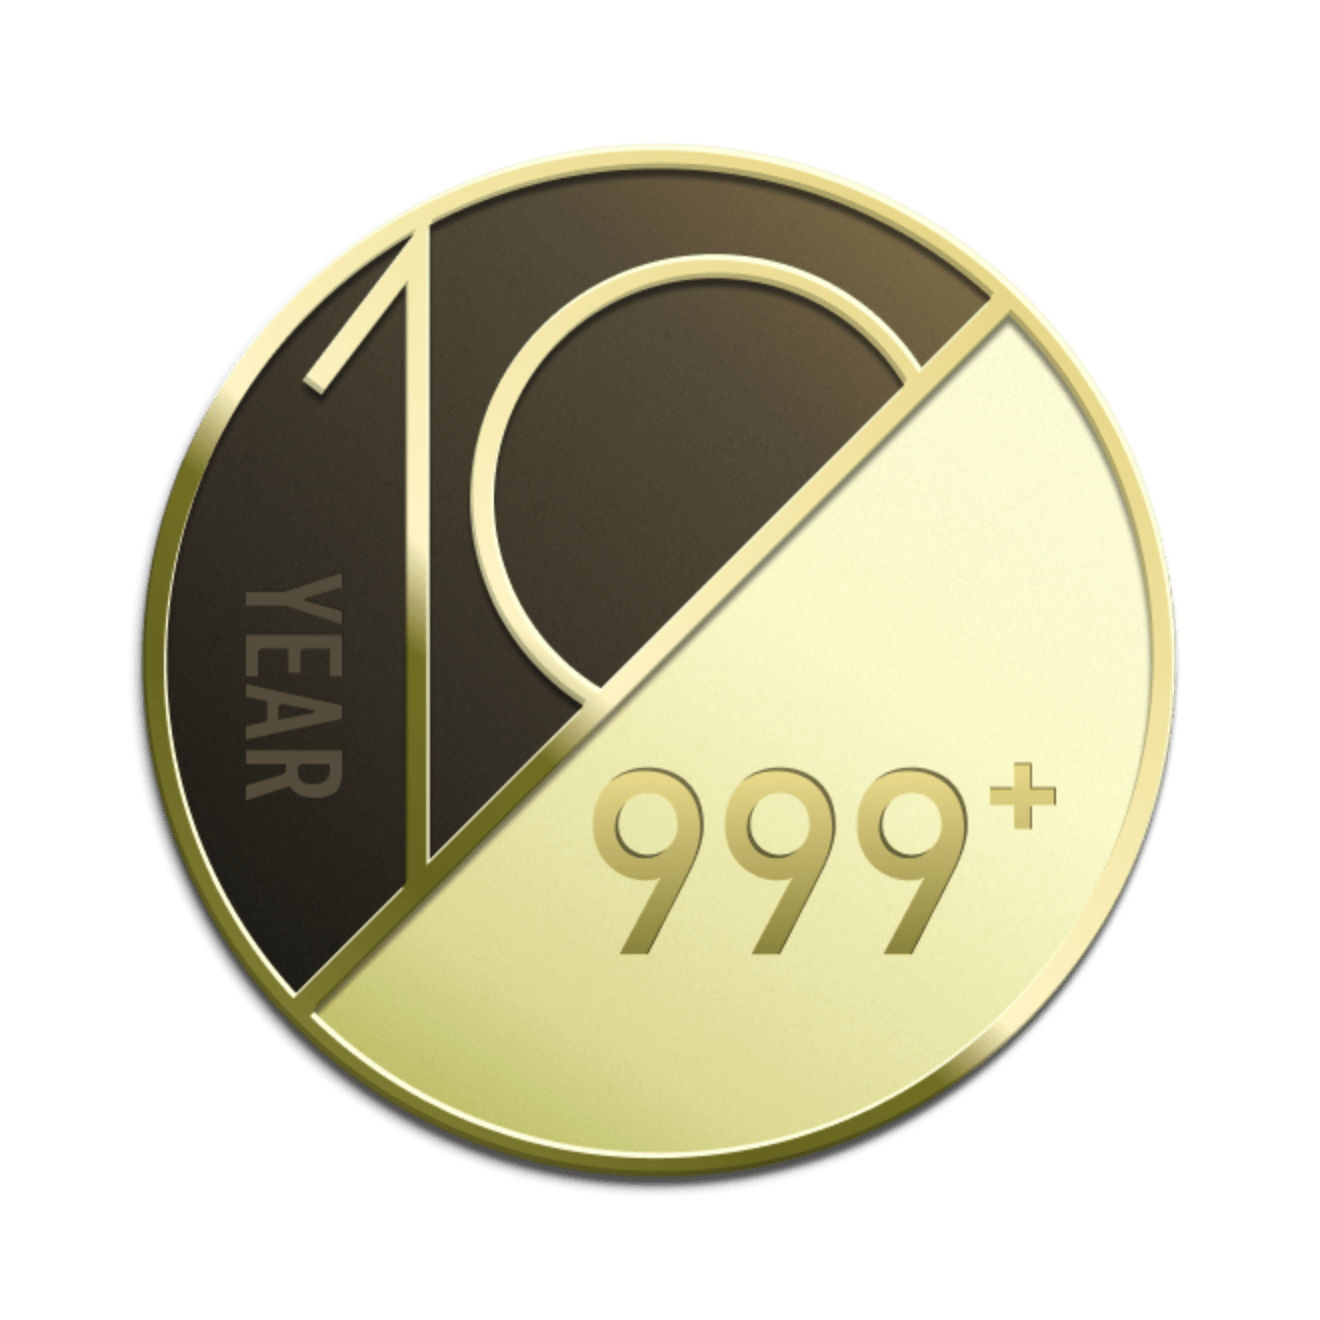
当然,一个人可以读过很多本书,我们这里做了限制,如果读过超过 1000 本书,就展示 999+
所以,最尊贵的勋章,是这个样子的:
勋章需要 2 种尺寸,可能的组合有:
10 年 * 1000 本 * 2 种尺寸 = 20000 个这样的量级,让设计师手撸,画到明年 423 才能画完。
于是简单搞个工具来批量生产它!解放人力。
我们主要用到:
一、使用合适的方式表达设计结构
二、模板渲染
使用 EJS 模板引擎,我们可以将勋章的设计模板化:
<div class="diagram">
    <div class="circle">
        <div class="rectangle">
            <div class="number-image-container">
                <!-- 动态渲染数字 -->
            </div>
        </div>
    </div>
</div>
三、使用 Puppeteer 截图
Puppeteer 是一个 Node.js 库,它提供了一个高级 API 来通过 DevTools 协议控制 Chrome/Chromium。在我们的项目中,它扮演着关键角色:
- 创建无头浏览器实例
const browser = await puppeteer.launch({
    headless: true,
    args: ['--no-sandbox', '--disable-setuid-sandbox']
});- 初始化画布
const page = await browser.newPage();
await page.setViewport({
    width: w,
    height: h,
    deviceScaleFactor: scale
});- 加载 HTML
await page.setContent(html, {
    waitUntil: 'networkidle0',
    timeout: waitTime
});- 截图
const screenshotBuffer = await page.screenshot({
    type: 'png',
    omitBackground: true,
    encoding: 'binary',
    fromSurface: true
});
四、让勋章生成得更快
为了提高生成效率,我们实现了多层次的并行处理机制:
- 工作进程池
const workers = Array.from({ length: parallelCount }, async () => {
    const browser = await puppeteer.launch({
        headless: true,
        args: ['--no-sandbox', '--disable-setuid-sandbox']
    });
    const page = await browser.newPage();
    await page.setViewport({ width: w, height: h, deviceScaleFactor });
    return { browser, page, busy: false };
});- 任务分配机制
const processTask = async (worker, number) => {
    worker.busy = true;
    try {
        const result = await createMedal(
            worker.page,
            year,
            number,
            worker.index,
            quality,
            compressionLevel,
            waitTime
        );
        return result;
    } finally {
        worker.busy = false;
    }
};- 动态负载均衡
const getIdleWorker = () => workers.find(w => !w.busy);
const allWorkersIdle = () => workers.every(w => !w.busy);- 进度监控
const updateProgress = (success = true) => {
    if (success) {
        completed++;
    } else {
        failed++;
    }
    if ((completed + failed) % 10 === 0 || (completed + failed) === total) {
        console.log(`进度: ${completed}/${total} (${Math.floor(completed/total*100)}%), 失败: ${failed}`);
    }
};
五、性能优化策略
-
资源管理
- 复用浏览器实例
- 动态调整并行数量
- 及时释放内存
-
渲染优化
- 使用
networkidle0等待策略 - 优化页面加载超时
- 控制内存使用
- 使用
-
并发控制
- 避免资源竞争
- 动态任务分配
- 错误重试机制
在我们的项目中,选择 networkidle0 策略的原因是:
- 确保所有图片资源完全加载
- 避免截图时出现未加载完成的内容
- 保证生成的勋章图片质量
六、图片压缩
勋章生成是生成完了,发现每一张都要 200-400 KB
一个几百 KB 的勋章,对于 H5 展示来说还是太大了,我们要压一下大小。
Sharp 是一个 Node.js 图片处理库,用它来搞一搞。
- 基础配置
const sharp = require('sharp');

// 配置默认参数
const defaultOptions = {
    quality: 80,        // 图片质量(0-100)
    compressionLevel: 9 // 压缩级别(0-9)
};- 图片处理流程
// 处理并保存图片
await sharp(screenshotBuffer)
    .png({
        quality: quality,           // 控制图片质量
        compressionLevel: compressionLevel, // 控制压缩级别
        palette: false,             // 不希望减少颜色,所以不使用调色板优化
        effort: 10                 // 压缩努力程度(1-10)
    })
.toFile(outputPath);- 压缩策略详解
-
质量控制(quality)
- 范围:0-100
- 值越大,图片质量越高,文件越大
- 值越小,图片质量越低,文件越小
- 建议值:80-90 之间,平衡质量和大小
-
压缩级别(compressionLevel)
- 范围:0-9
- 0:最快但压缩率最低
- 9:最慢但压缩率最高
- 建议值:6-9 之间,根据需求平衡
-
批量处理
// 并行处理多张图片
const processImage = async (buffer, options) => {
    return sharp(buffer)
        .png(options)
        .toBuffer();
};

const results = await Promise.all(
    images.map(img => processImage(img, options))
);- 错误处理
try {
    await sharp(buffer)
        .png(options)
        .toFile(outputPath);
} catch (error) {
    console.error('图片处理失败:', error);
    // 降级处理或重试
}
在我们的项目中,通过调整这些参数,我们实现了:
- 文件大小减少 40-60%
- 保持图片清晰度
- 处理速度提升 30-50%
七、使用示例
# 生成单个勋章
node index.js --year 2023 --number 42

# 生成某年的所有勋章
node index.js --year 2023 --all

# 使用并行模式生成
node index.js --year 2023 --all --parallel 4
八、技术要点总结
-
模板化设计
- 使用 EJS 模板引擎实现勋章的动态渲染
- 支持自定义背景图片和数字样式
- 灵活处理不同位数的数字显示
-
自动化生成
- 支持批量生成指定年份的所有勋章
- 支持并行处理提高效率
- 自动处理图片压缩和优化
-
命令行工具
- 提供友好的命令行接口
- 支持多种参数配置
- 灵活控制生成过程
九、结语
这个项目展示了如何将现代 Web 技术应用于图片生成领域。通过合理的架构设计和性能优化,我们实现了一个高效、可靠的勋章生成工具。这不仅提高了工作效率,也为类似需求提供了可参考的解决方案。