解决了一个豆包还没解决的 Markdown 渲染问题
背景
在近期公司业务开发中,需要对大模型生成的 Markdown 文本进行解析并在移动端 WebView 上渲染,我们遇到了一个 Markdown 渲染问题:
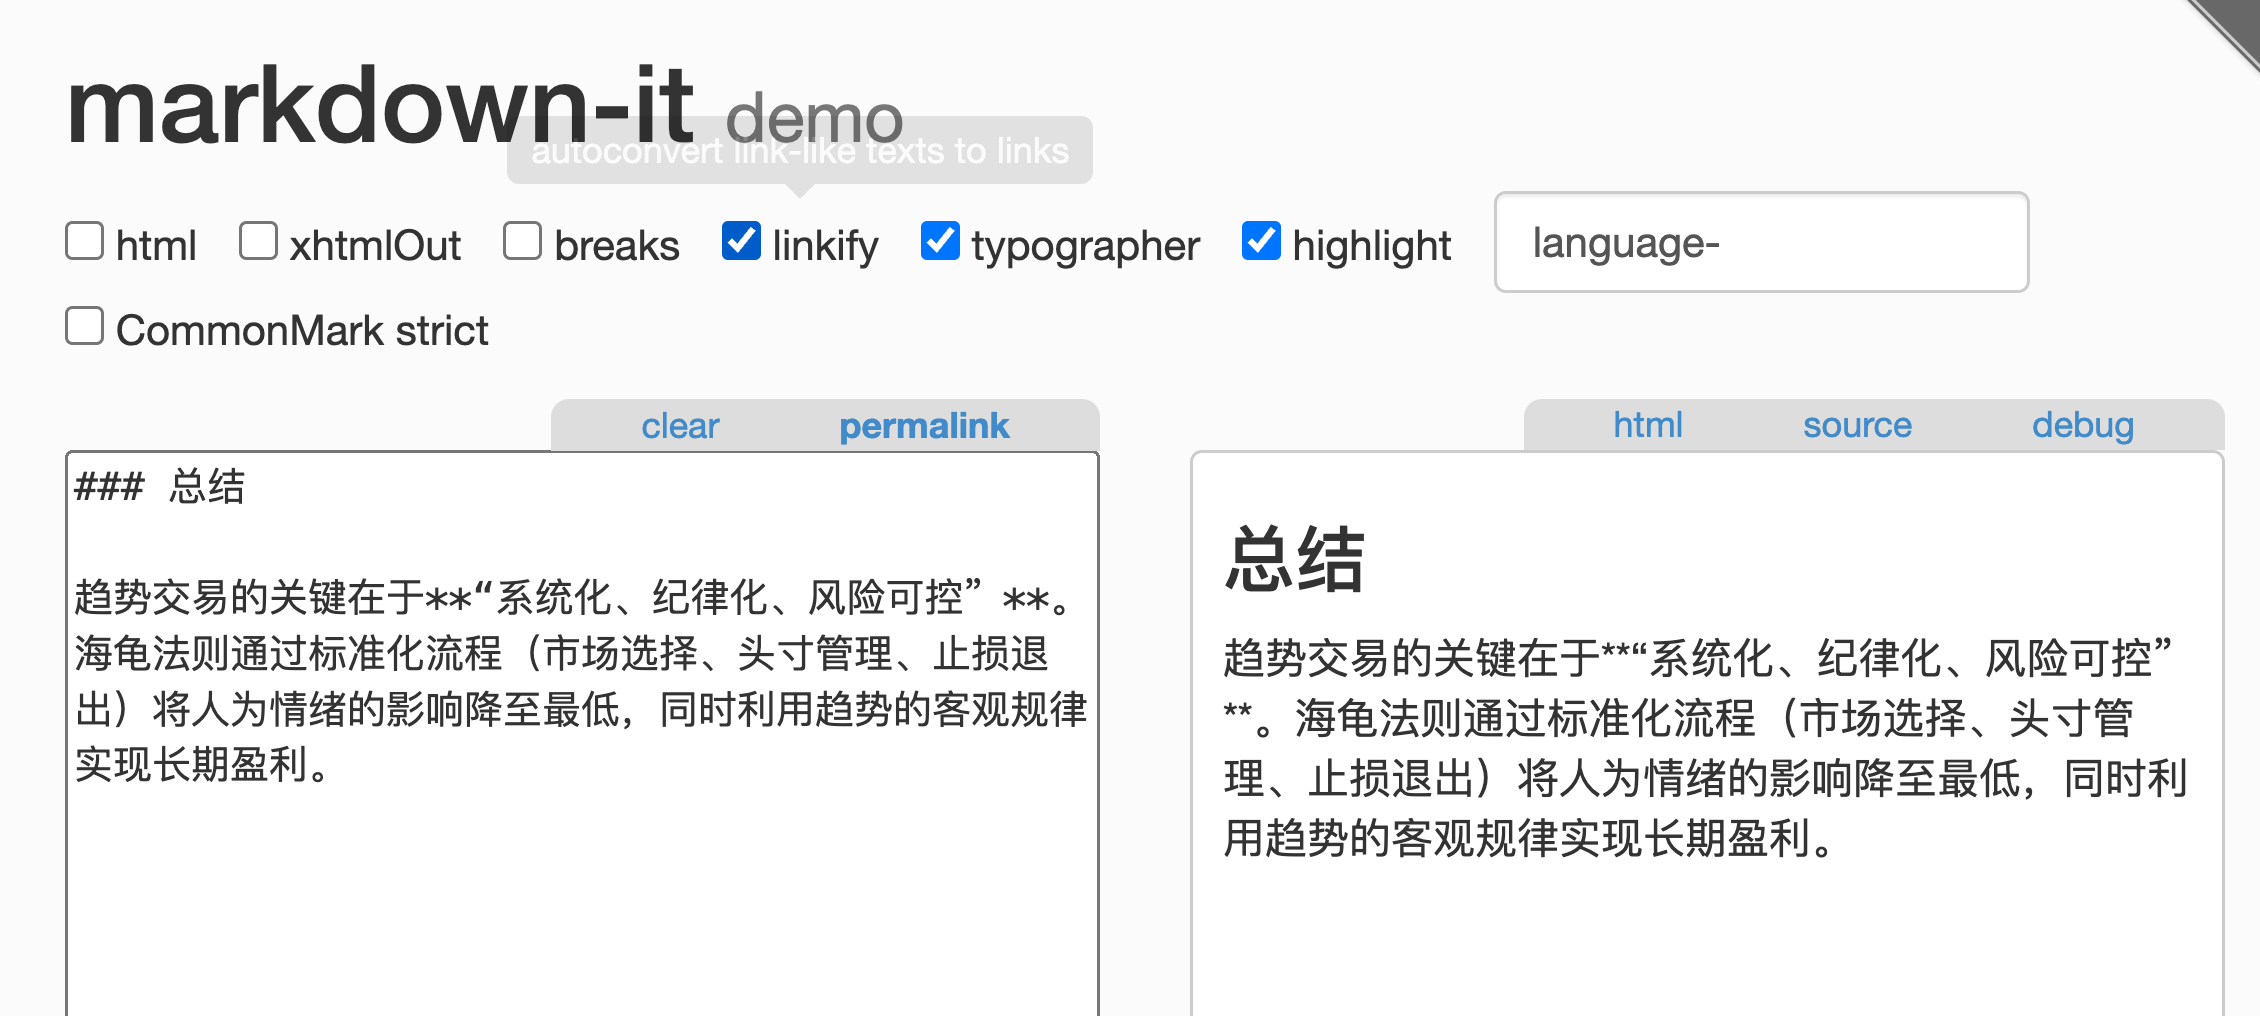
AI 生成的Markdown文本中,部分加粗内容无法正确解析,导致原始星号直接显示在页面上。
经过深入分析,我们发现这是 markdown-it 解析器的特定规则导致的,并通过巧妙的预处理方案解决了该问题。
问题表现
当 AI 生成的 Markdown 文本中存在类似 **我是加粗文本** 的格式时,渲染结果本应是 我是加粗文本,但有时会变成 **我是加粗文本**,如下图:
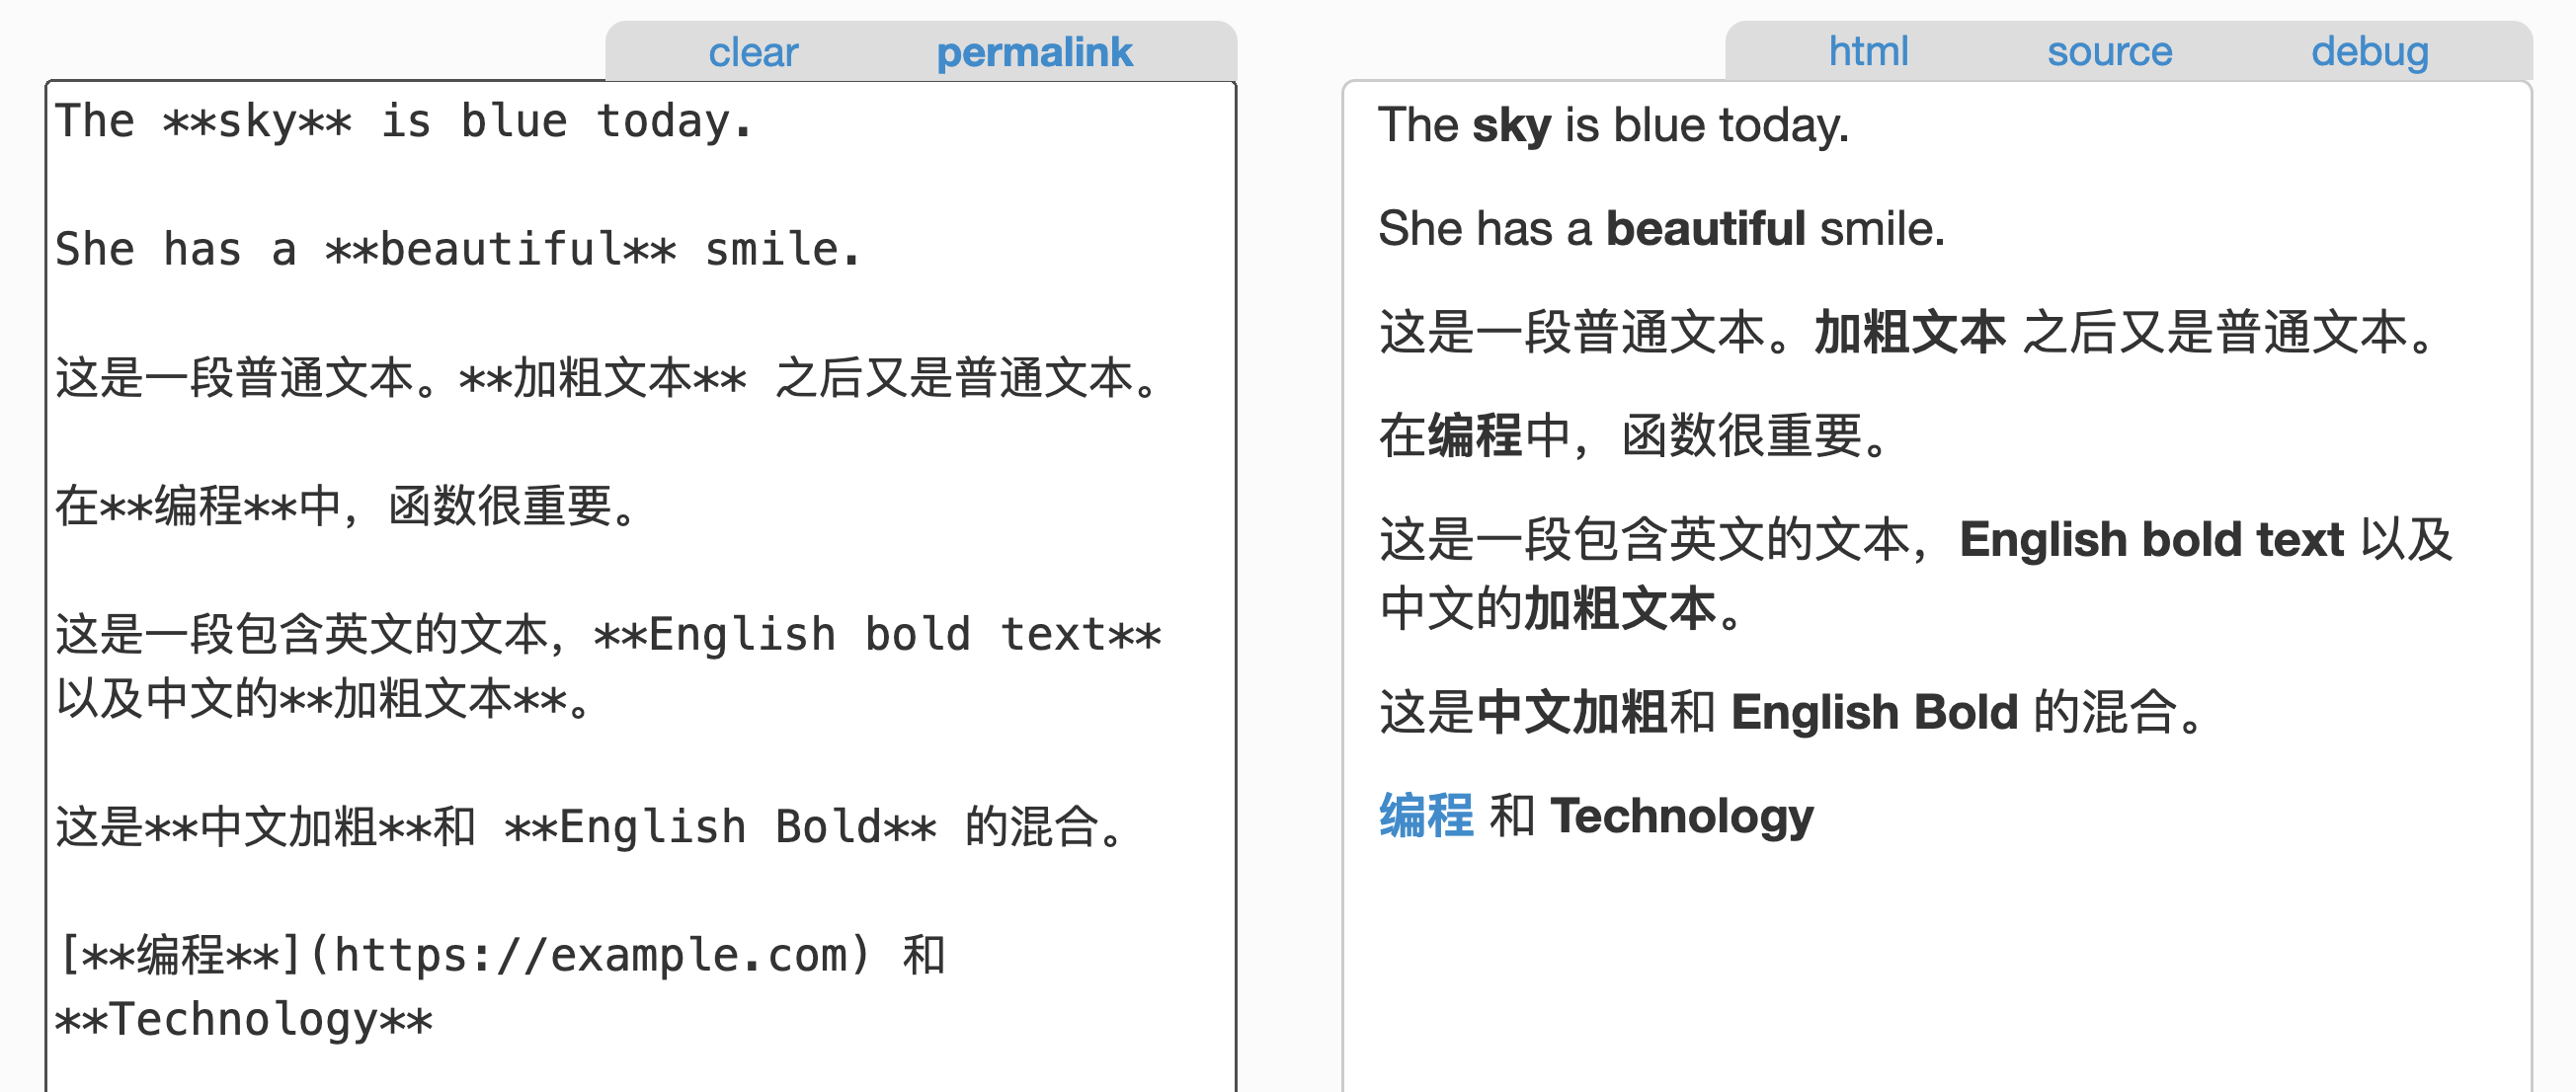
经过多次复现,发现这些基本 case 都是没问题的:
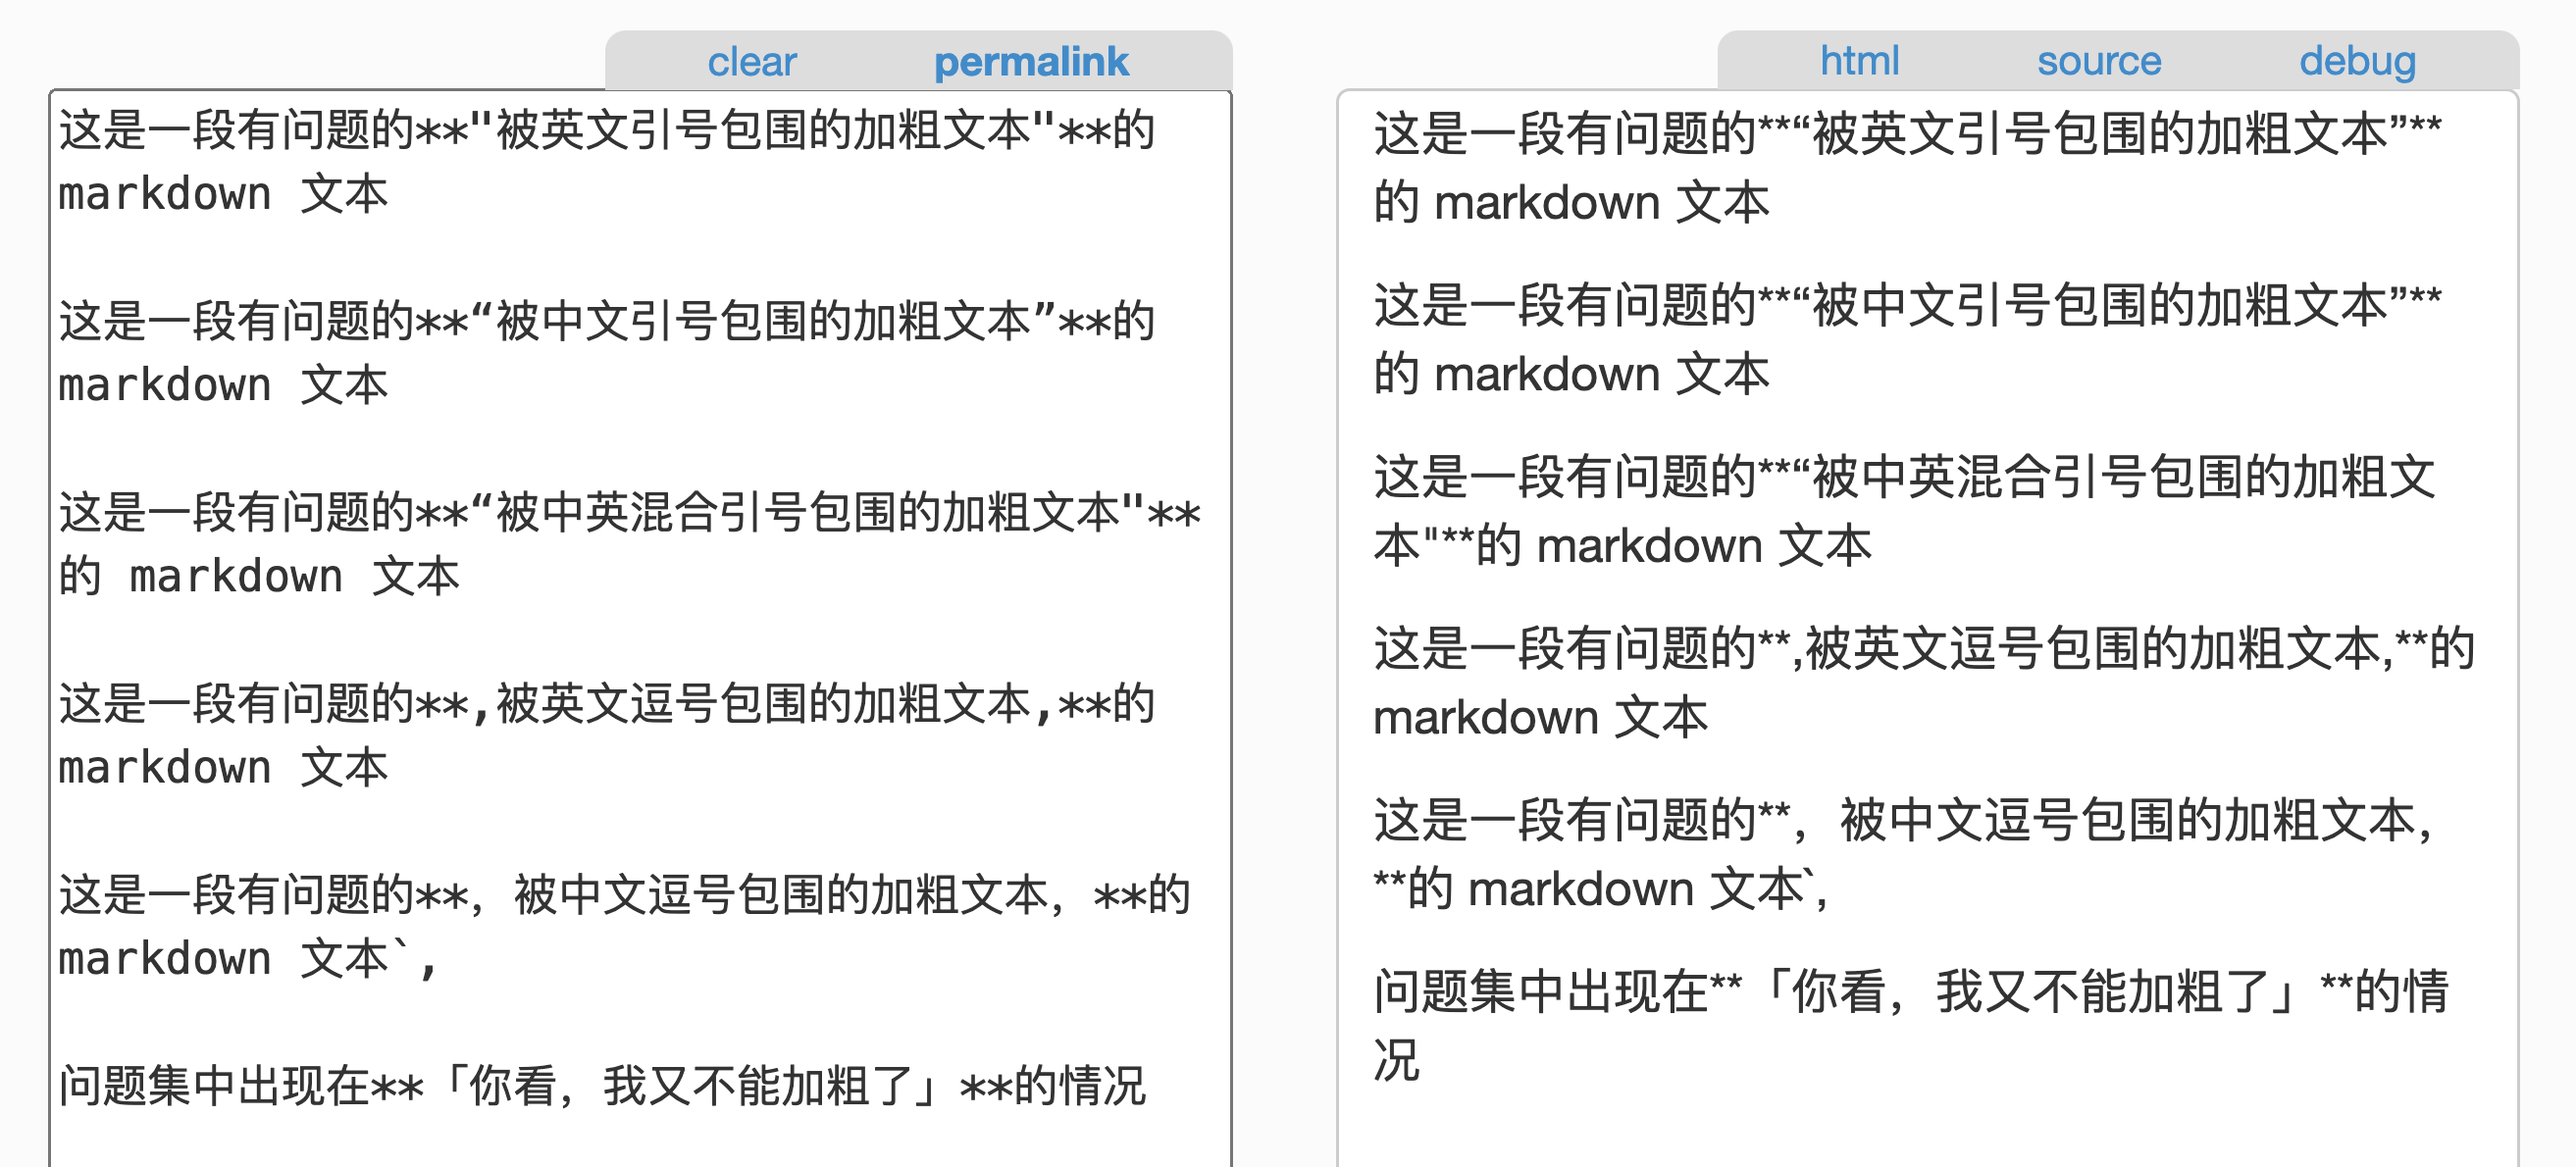
❗问题集中出现在**「双星号紧跟着标点符号(无论中文还是英文标点)」**的情况:
如果你仔细点看,你会发现我描述问题的这句话 👆,加粗识别也是有问题的
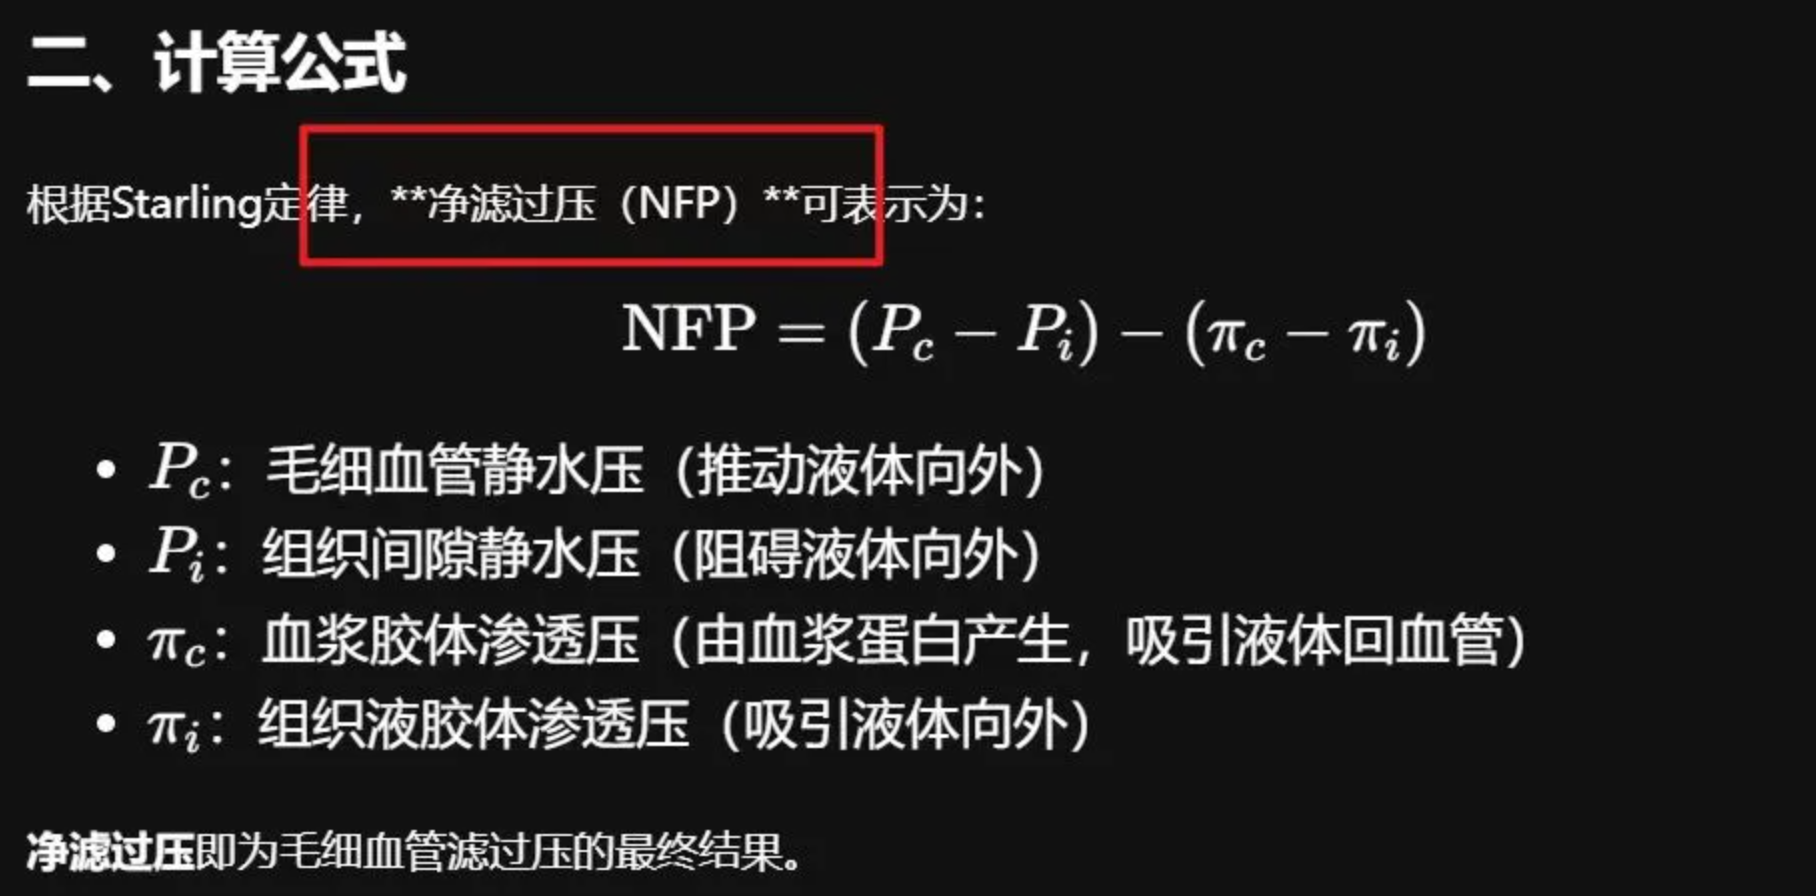
当时查这个问题的时候,大概是 3-11 左右,当时 DeepSeek 官网也有这个问题,我一想,吹牛逼的机会这不就来了吗,马上查一下😂
原因分析
结合 Markdown 处理的基本流程考虑:
- tokenizer 将输入的 Markdown 字符串转为 tokens
- 将 tokens 转换为 AST
- 将每个 AST 块的渲染权交给开发者定制(或者使用内置默认样式)
怀疑背后原因是解析器在将 Markdown 文本转 token 的时候,识别到了双星号,但未将其作为加粗结构的开启符,导致双星号被当成普通文本处理,从而直接显示出来。
通过查阅 markdown-it 仓库的指示及其源码,可以发现解析器的核心就是三个文件:
合理猜测,我们需要排查的规则是「加粗规则」,加粗文本属于 inline 元素,可以先看一下 parser_inline.mjs,果然找到了一条叫 emphasis 的规则:
const _rules = [
  ['text',            r_text],
  ['linkify',         r_linkify],
  ['newline',         r_newline],
  ['escape',          r_escape],
  ['backticks',       r_backticks],
  ['strikethrough',   r_strikethrough.tokenize],
  ['emphasis',        r_emphasis.tokenize], // here
  ['link',            r_link],
  ['image',           r_image],
  ['autolink',        r_autolink],
  ['html_inline',     r_html_inline],
  ['entity',          r_entity]
]
进去之后,果然,这条规则就是专门处理被 _ 或 * 包围的文本的,并且核心逻辑应该位于这个函数里:
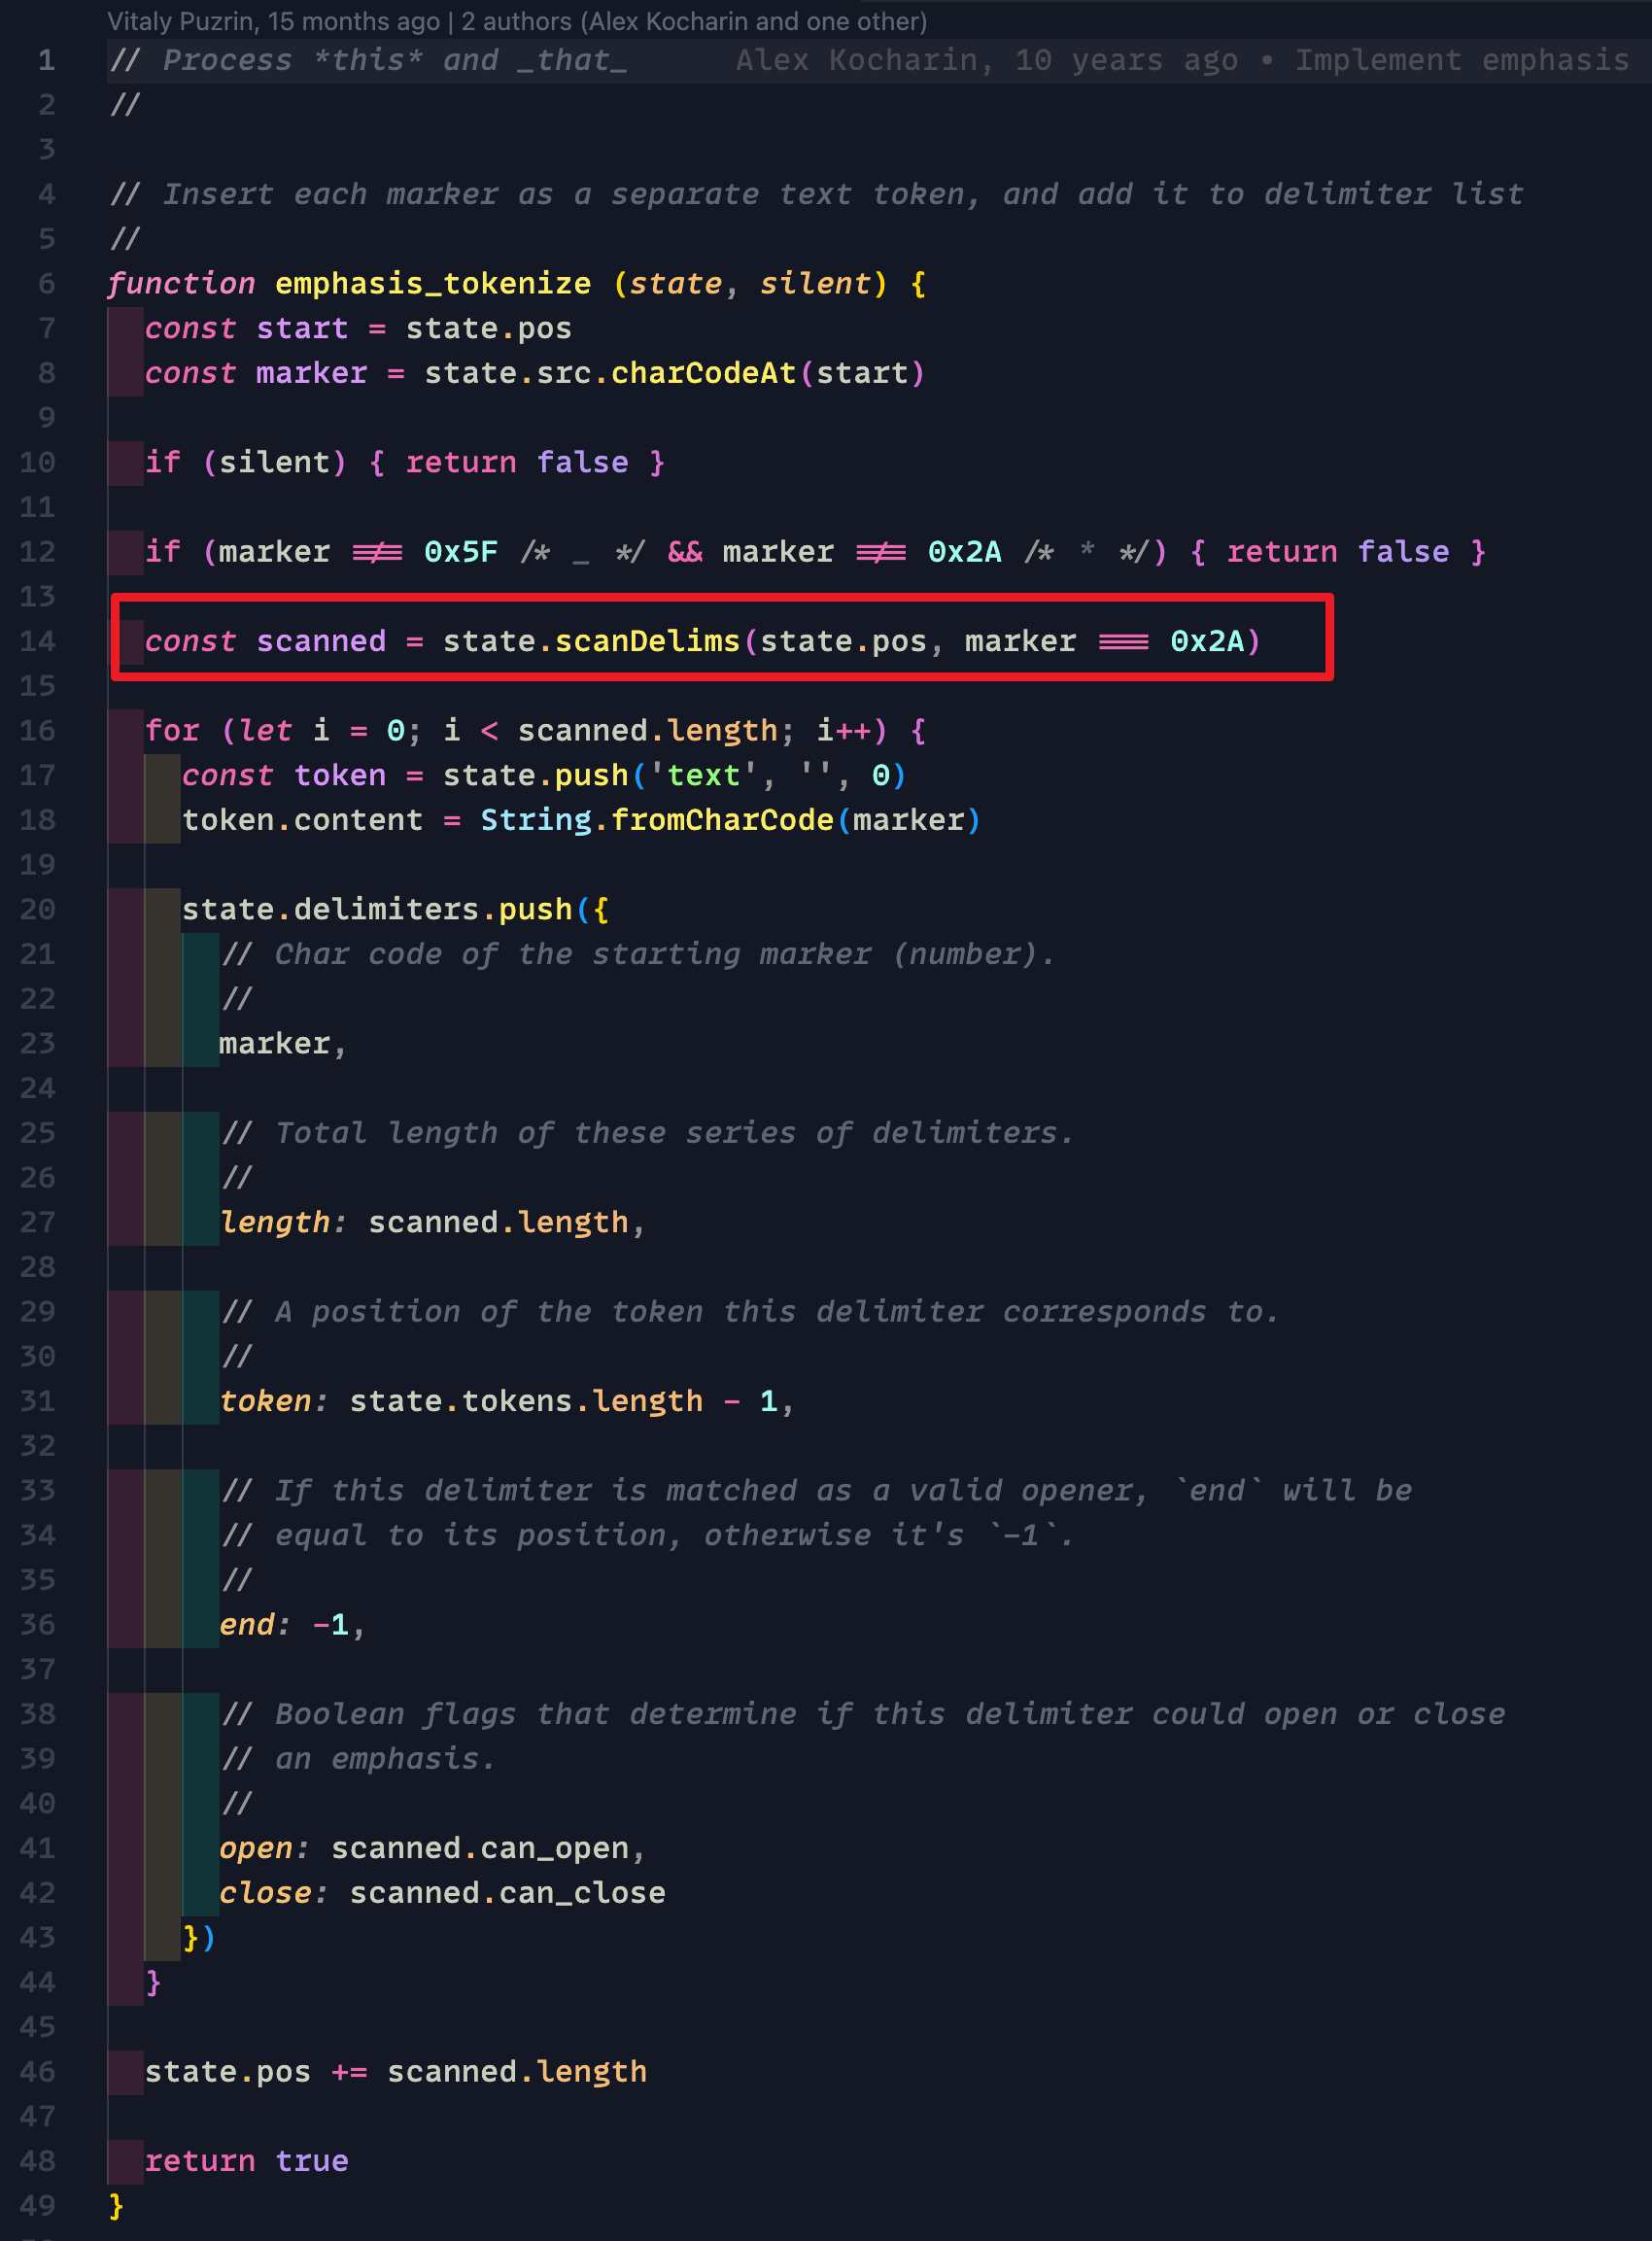
继续往里看,从注释以及大量的字符位置判断处理,可以大胆猜测这就是我们想找的代码:
Scan a sequence of emphasis-like markers, and determine whether it can start an emphasis sequence or end an emphasis sequence. 扫描加粗标记,并判断他们是否能够开启一段加粗文本序列。
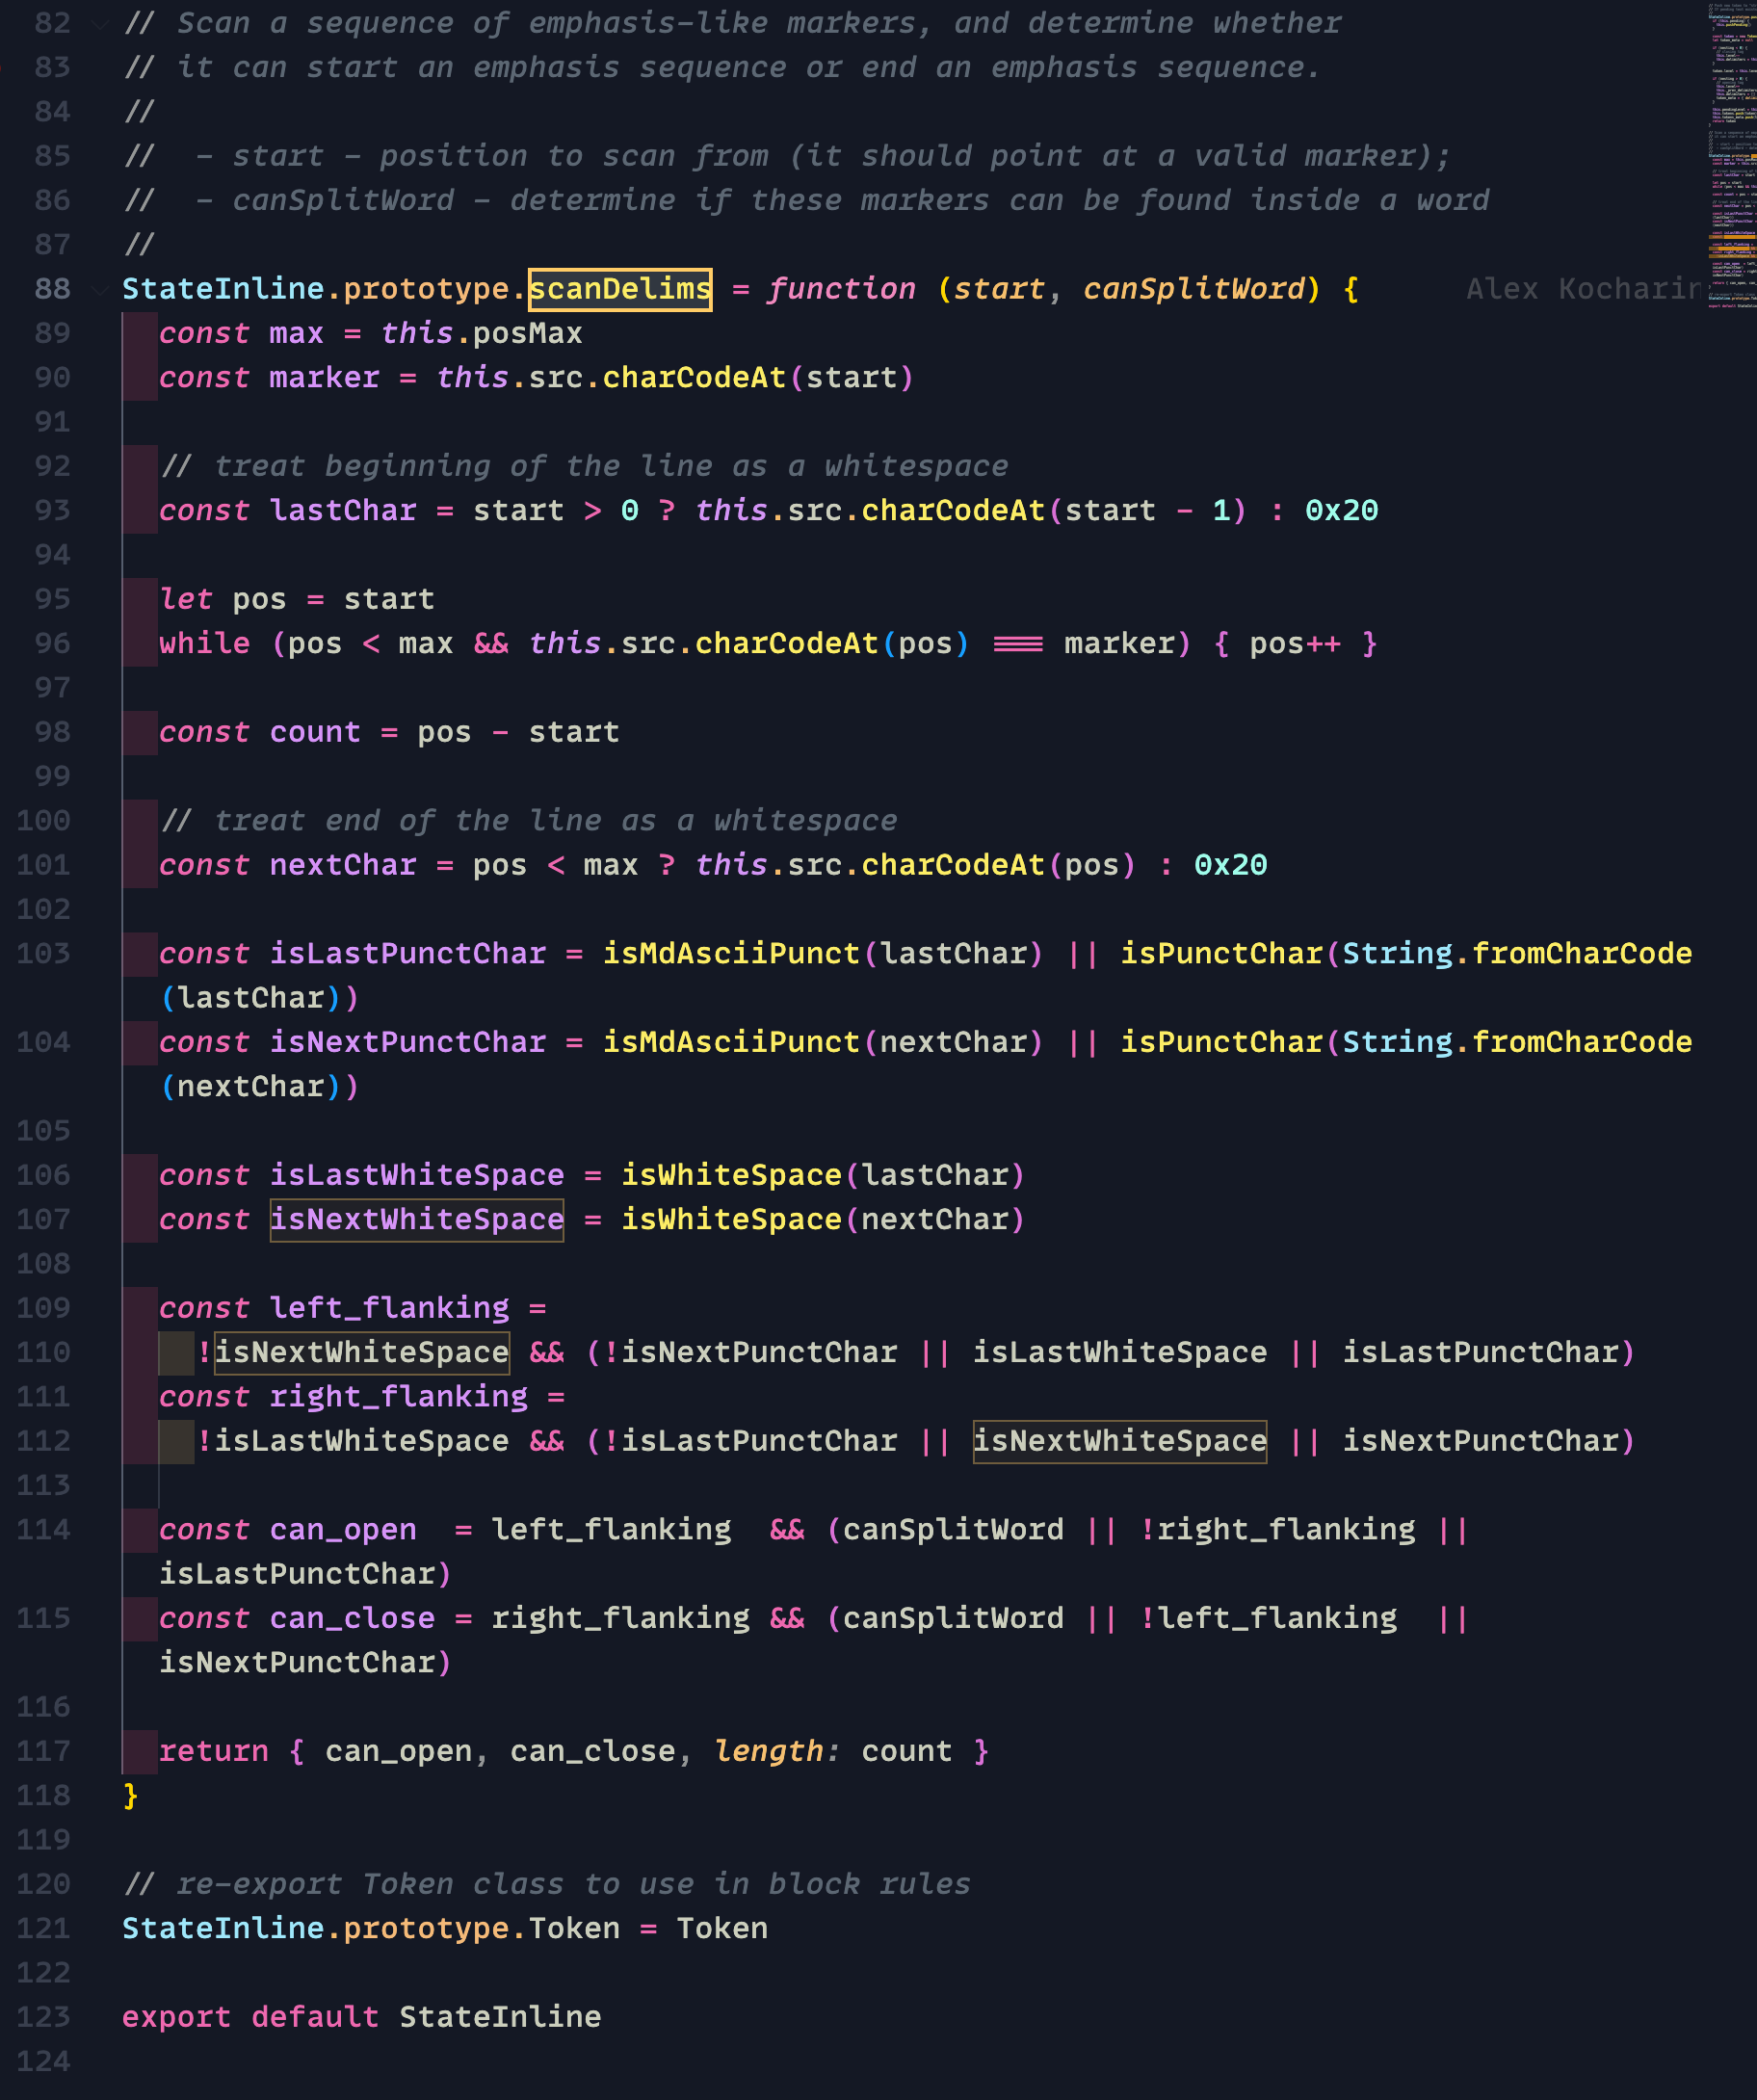
加粗符号能否开启 or 关闭一段加粗序列,我们只需要关注 can_open 和 can_close 的判断条件
从上一段代码可以注意到,星号加粗的情况,带进来的第二个参数 canSplitWord 是 true,所以等价于:
只需要看:
left_flanking为 true 就是可开启,否则不可开启right_flanking同理
我们分析下 left_flanking 的情况(因为 right_flanking 和他是镜面对称的,可以以此类推)
我们将双星号前后分别称为 lastChar 和 nextChar:
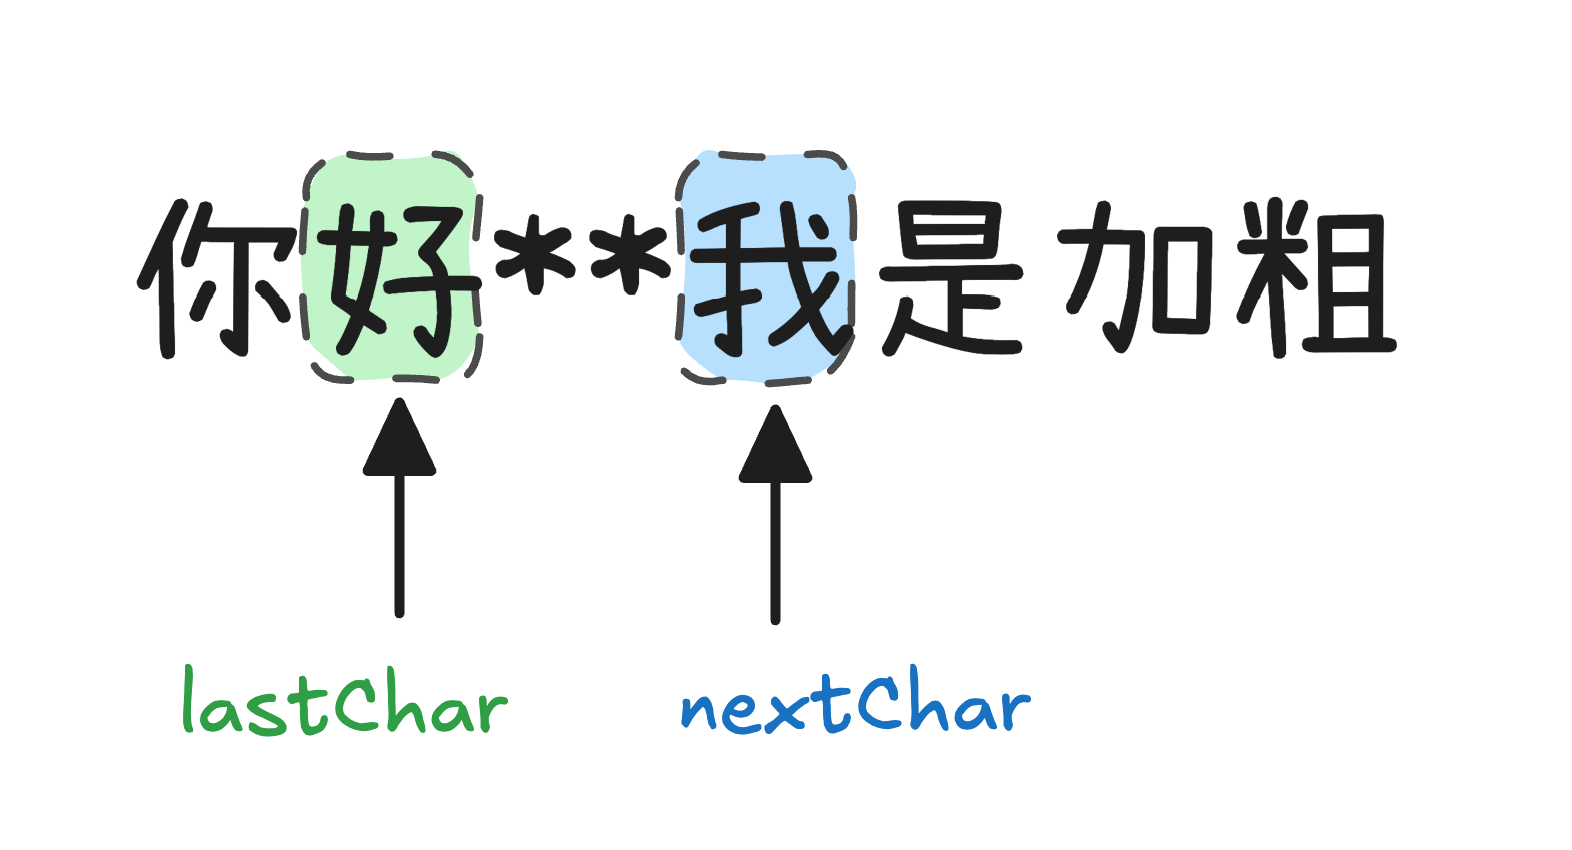
所以我们发现双星号(**)被解析为加粗开启符的条件是:nextChar 必须非空, 再满足以下三个条件任意一个:
- nextChar 不是标点
- lastChar 是空格
- lastChar 是标点
这里听起来有点绕,其实用图来表示很简单:
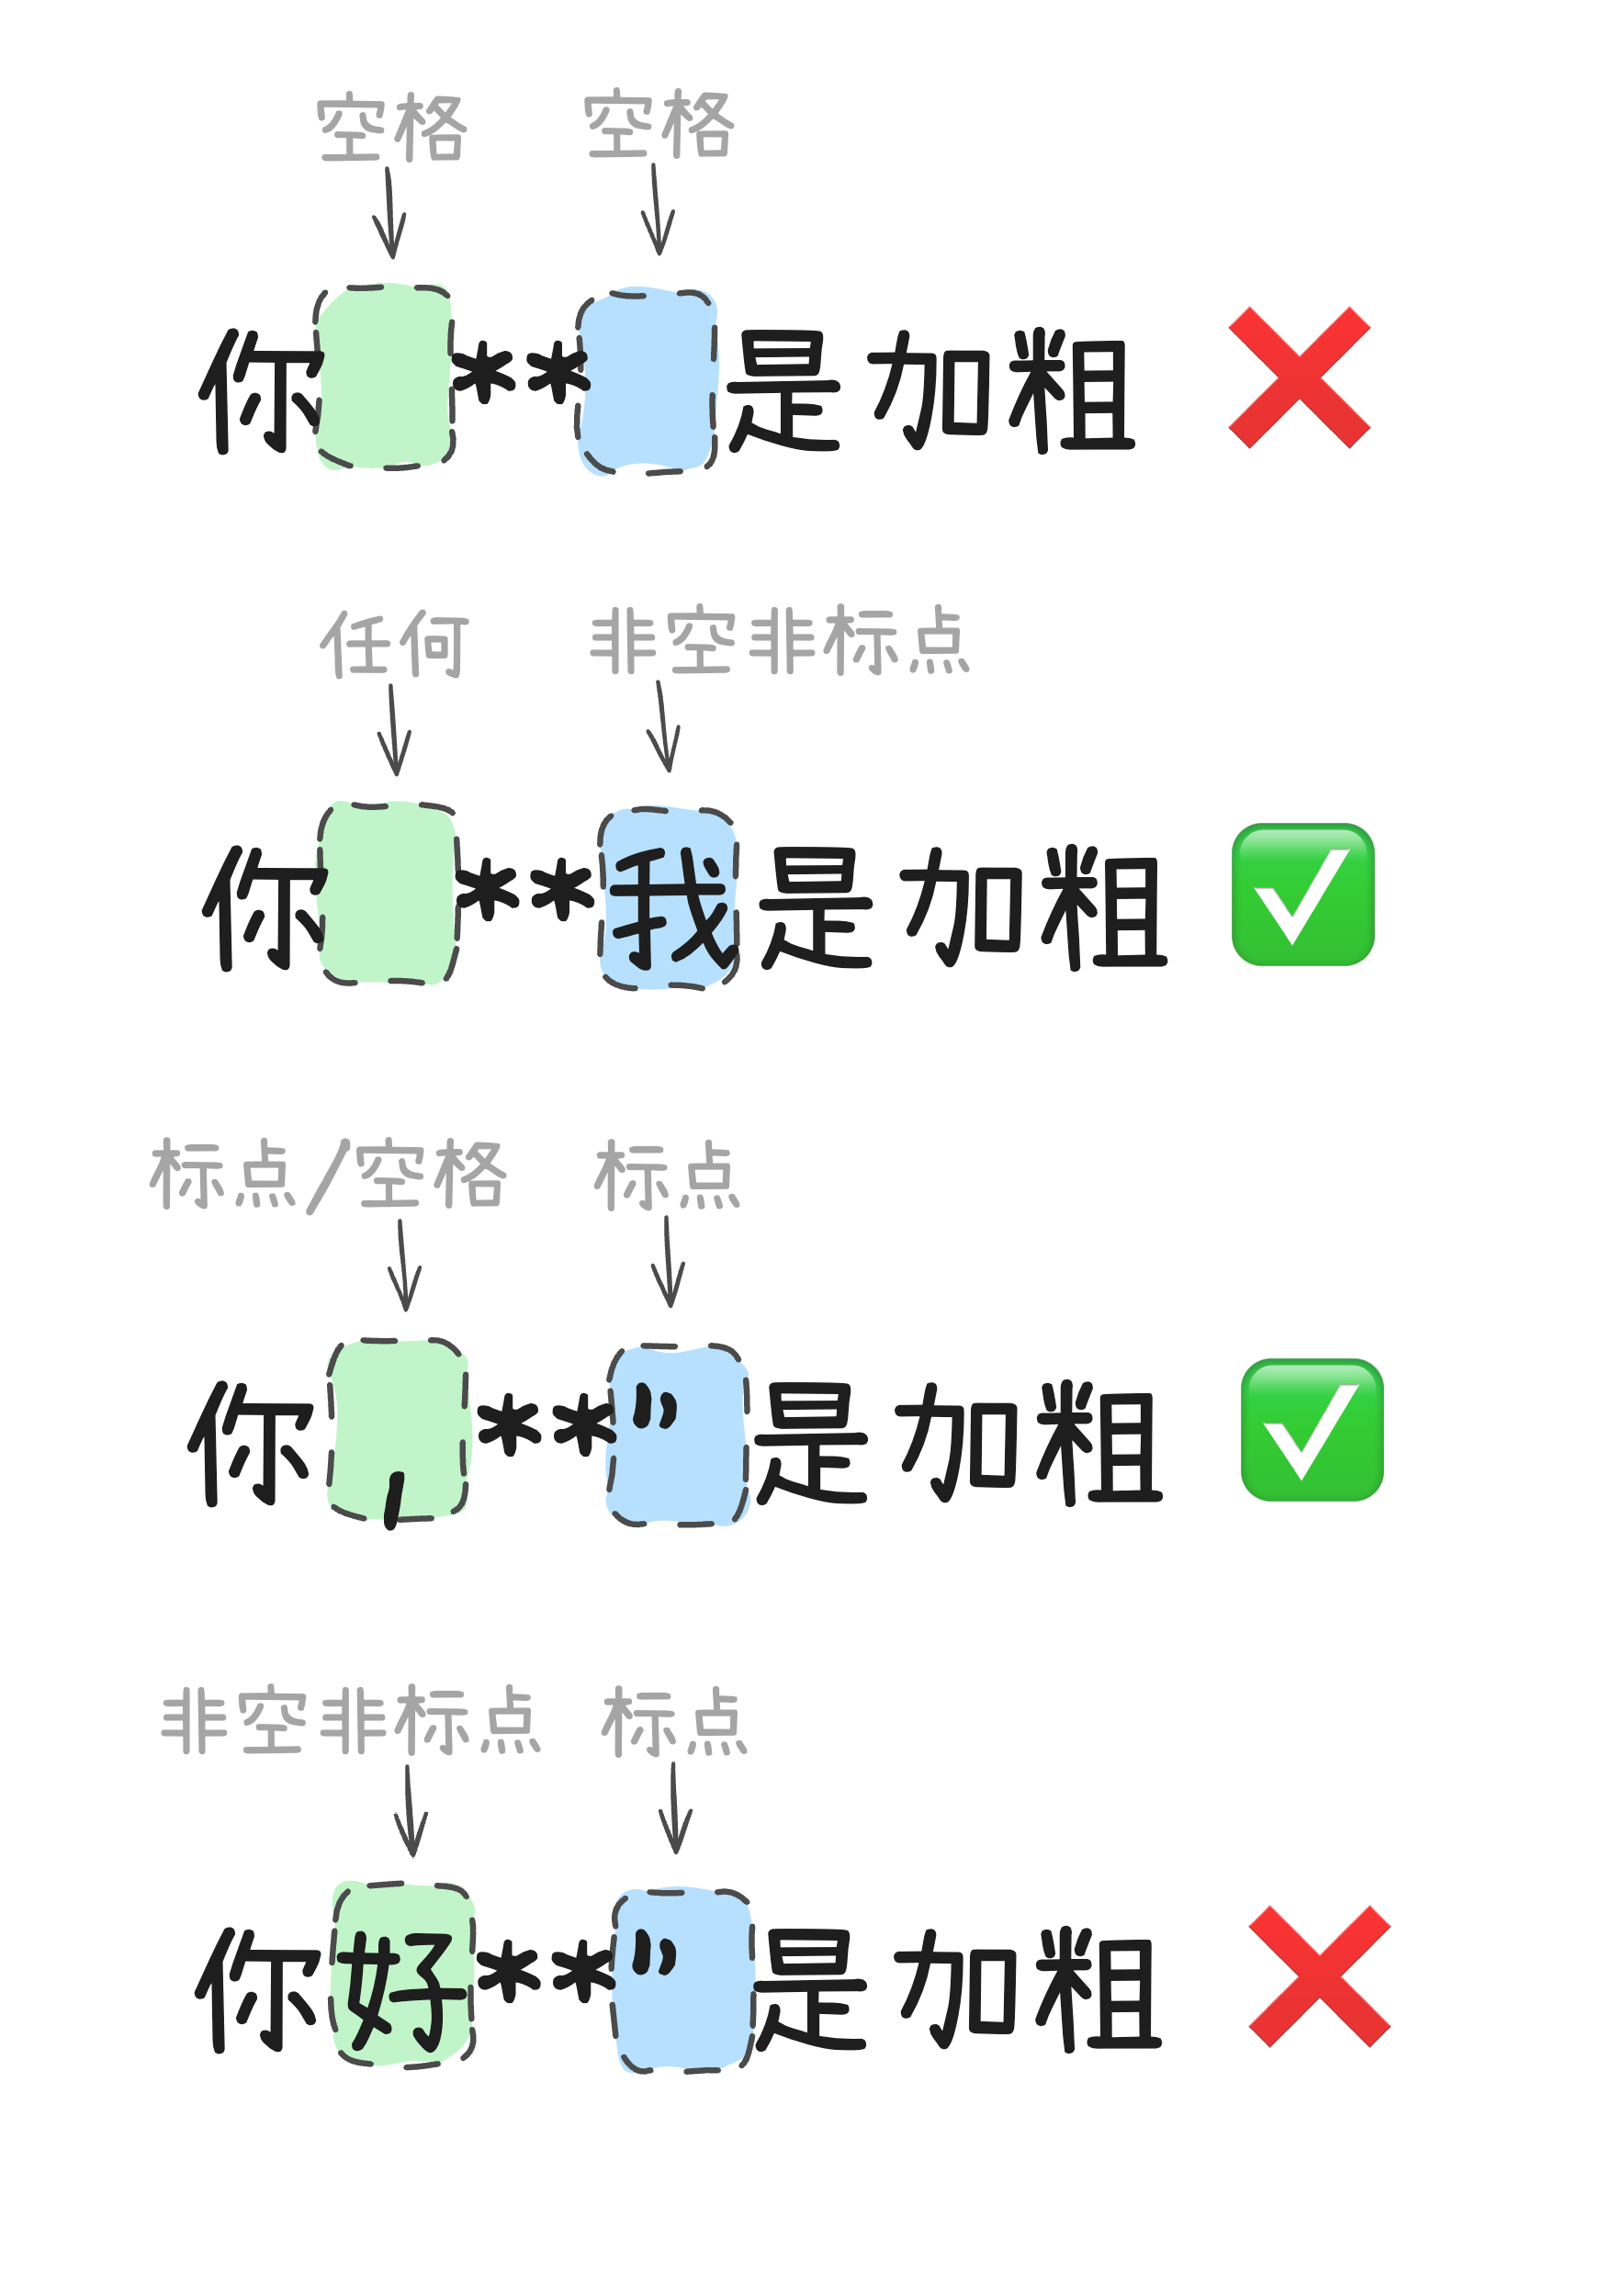
回顾一下我们最常见的 bad case,其实就是第四种情况,本应作为开启符的双星号,后面跟了个中文/英文引号,前面又是个汉字(非标点),所以最后出来 can_open 为 false
解决思路
知道了原因之后,还得想办法解决,解决思路无非是这几个之一:
- 修改解析器源码,让我们的 case 也能通过
- 想办法让我们的 case 变成解析器认可的情况
方法 1 本质上是通过修改解析库的公共方法来「修改规则」,可能影响面短时间有点难摸清楚
方法 2 是在现有的规则里找漏洞,绕过去
我的大佬同事 @gtbl 提了一个办法: 在所有双星号两边加两个零宽空格
回过头来看看这个解析器是怎么判断空格的:
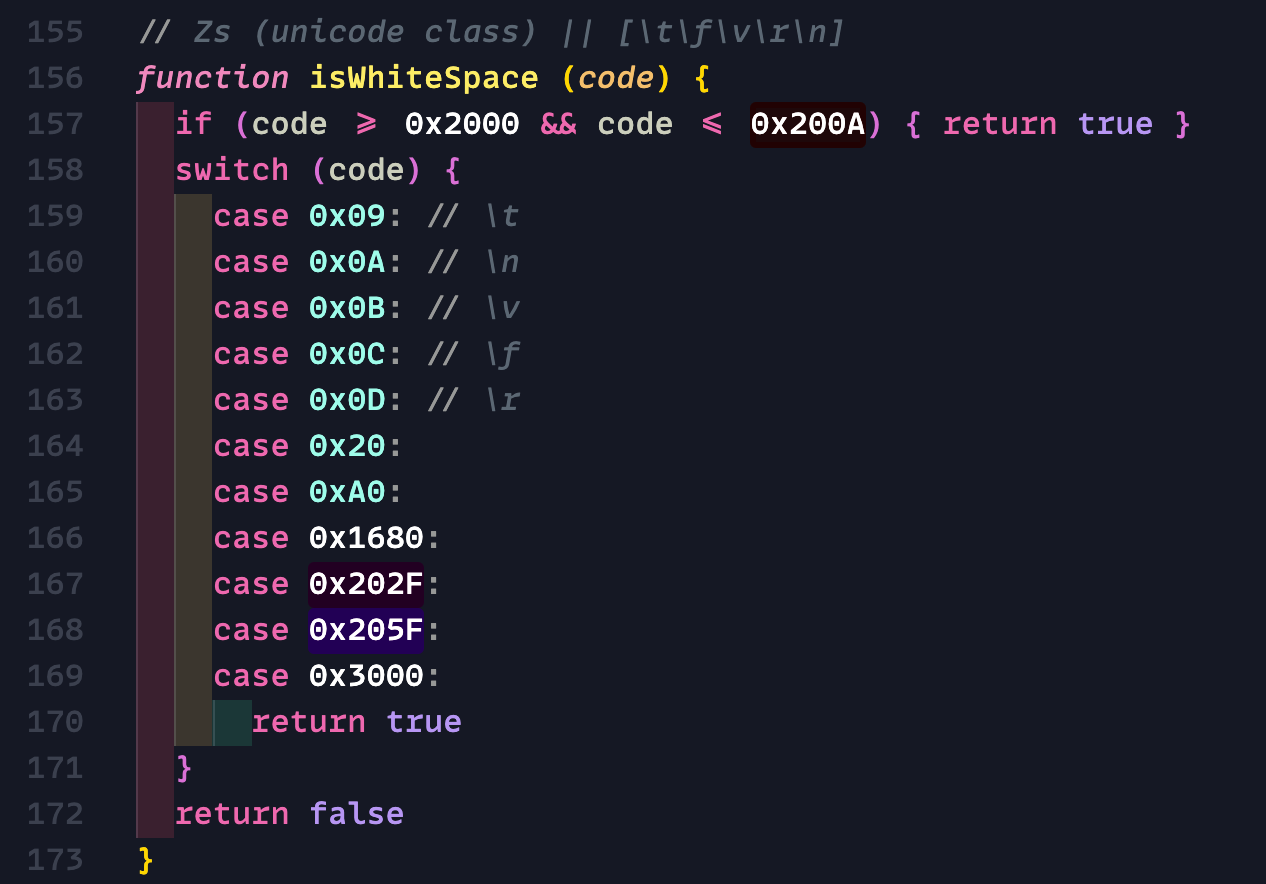
我们惊喜地发现:零宽空格 \u200B 逃过了这个判断,换句话说,如果遇到在双星号旁边的零宽空格,解析器会把它认为是「非空格」字符
那么我们的情况就变成了:
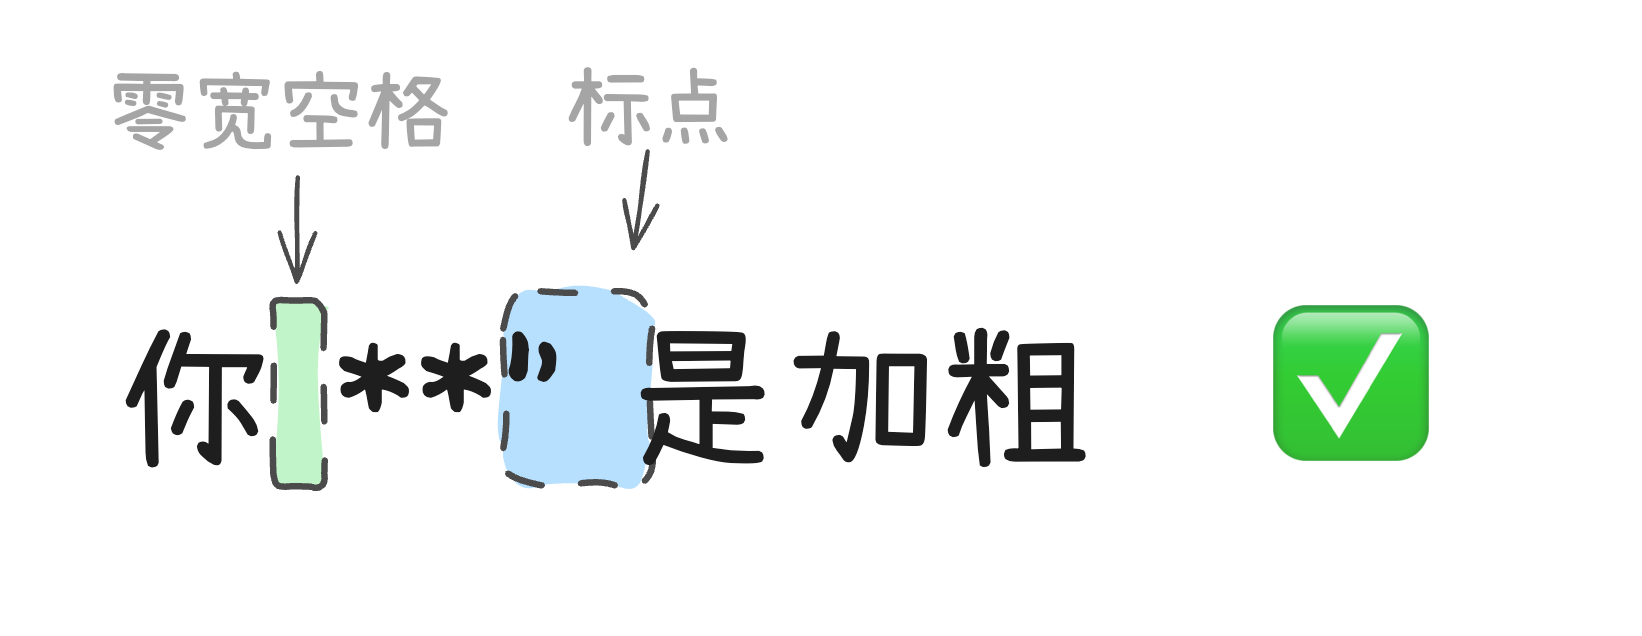
还有个小细节:对于我们(使用这个解析器的人)来讲,不太好判断一个双星号是用来开启还是用来关闭的,于是我们索性在所有双星号两边都加上零宽空格,也是能通过检测的。
具体操作
在「前处理」阶段修改 Markdown 字符串:在连续的双星号前后插入零宽空格符(\u200B),强制分隔星号与标点的直接接触。
替换方法
注意:因为 ** 被替换成 \u200B**\u200B,需要避免循环替换的问题
const addZeroWidthSpaceAroundBoldMarkers = (markdown: string) => {

  const TempMark = '\uFFFF'; // 使用一个不常见的字符作为临时标记
  // 第一步:将已经被零宽空格符包围的 ** 替换为临时标记
  const markedMarkdown = markdown.replace(/\u200B\*\*\u200B/g, TempMark);
  // 第二步:将剩余的 ** 替换为加上零宽空格符的形式
  const replacedMarkdown = markedMarkdown.replace(/\*\*/g, '\u200B**\u200B');
  // 第三步:将临时标记还原为原来的形式
  const finalMarkdown = replacedMarkdown.replace(new RegExp(TempMark, 'g'), '\u200B**\u200B');
  return finalMarkdown;
}集成示例
在使用Markdown-it渲染前调用预处理函数:
import MarkdownIt from 'markdown-it';

const md = new MarkdownIt();

// 前处理文本
const processedText = addZeroWidthSpaceAroundBoldMarkers(aiResponseMarkdown);

// 渲染
const html = md.render(processedText);
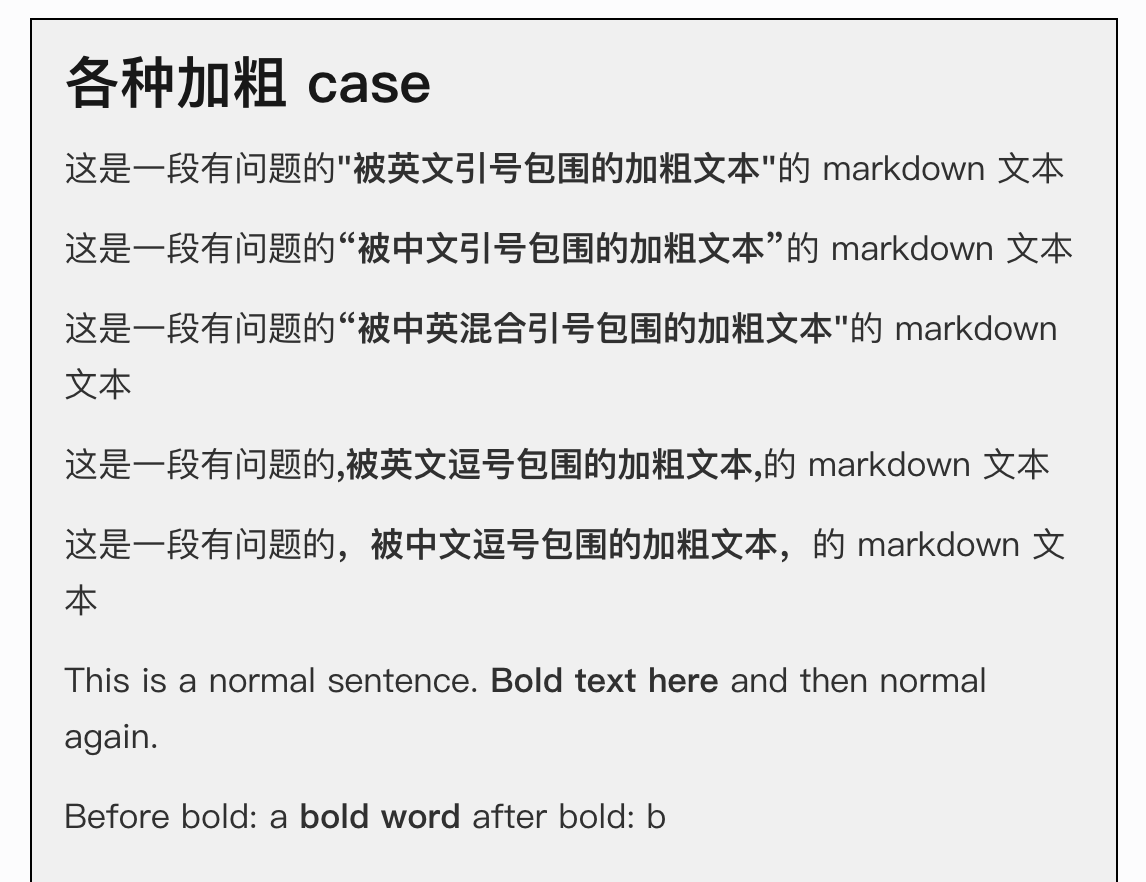
效果验证
总结
- 问题本质:markdown-it 对特殊符号组合的解析规则限制;
- 解决方案:通过零宽空格符破坏符号相邻关系,不破坏规则,而是与已有的规则共存;
- 扩展思考:预处理是解决解析器限制的通用手段,可应用于其他类似场景。
感谢 @gtbl 提供的解决思路,非常牛逼。