emoji 的长度到底是多少?UTF-16 下 emoji 字符串原理探究
0 前言
在日常前端开发过程中,我们经常会与 emoji 打交道。相信刚入门的新手们或多或少会遇到类似这样的问题:
- 使用
split方法拆开含有 emoji 的字符串,拆坏了 - 使用
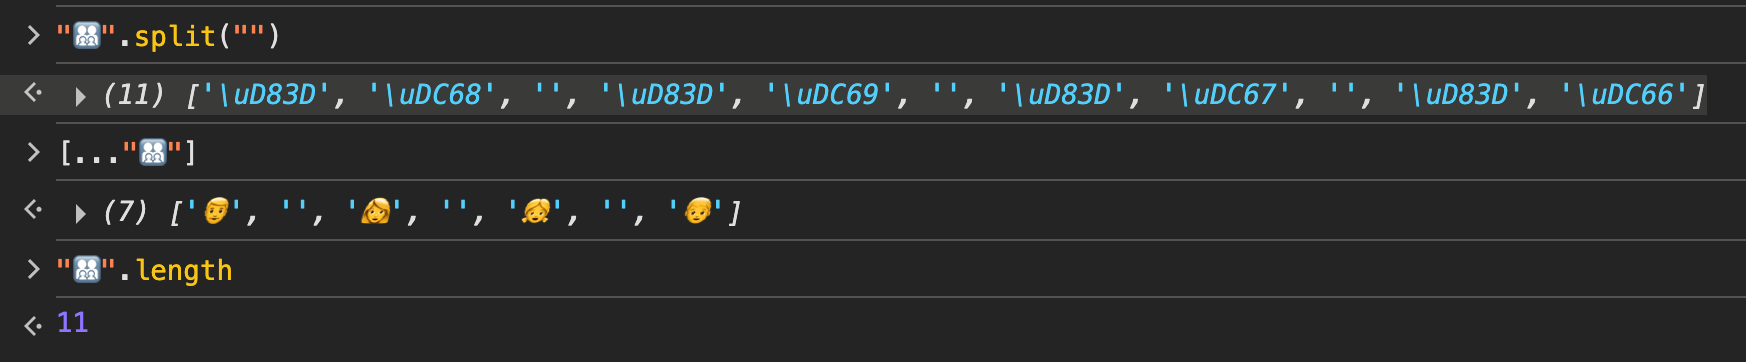
.length获取含 emoji 字符串的长度,发现好像不太对劲 - 处理不当,正文出现一些奇怪的问号、框框,到底是什么?
在实际开发中,其实我们的需求十分明确:
- 正确地显示含 emoji 的字符串
- 在有切分需求(例如逐字 fade-in 动画)时,正确地切开含 emoji 的字符串
- 正确计算含 emoji 字符串的长度。
太长不看版:倘若你无暇深入探究原理,可以直接使用 runes.js ,直接引入源码 or 安装后直接使用即可,该库导出了两个函数 runes 和 substr 用于对含 emoji 的字符串执行正确的切分、取子串操作。未压缩的源代码只有 160 行左右。
但如果我们想要知其所以然,就有必要深入研究一下,笔者在研究 runes.js 的源码过程中,顺带了解了一些 emoji 的常见模式,其实还挺有趣的,给各位看官介绍一下。
1 前置知识
先来一波字符编码的前置知识补充,熟悉的大佬可以直接跳过。
注意,这里并非直接 copy AI 的回答,笔者将用自己的理解引出所有必要的概念。
Unicode
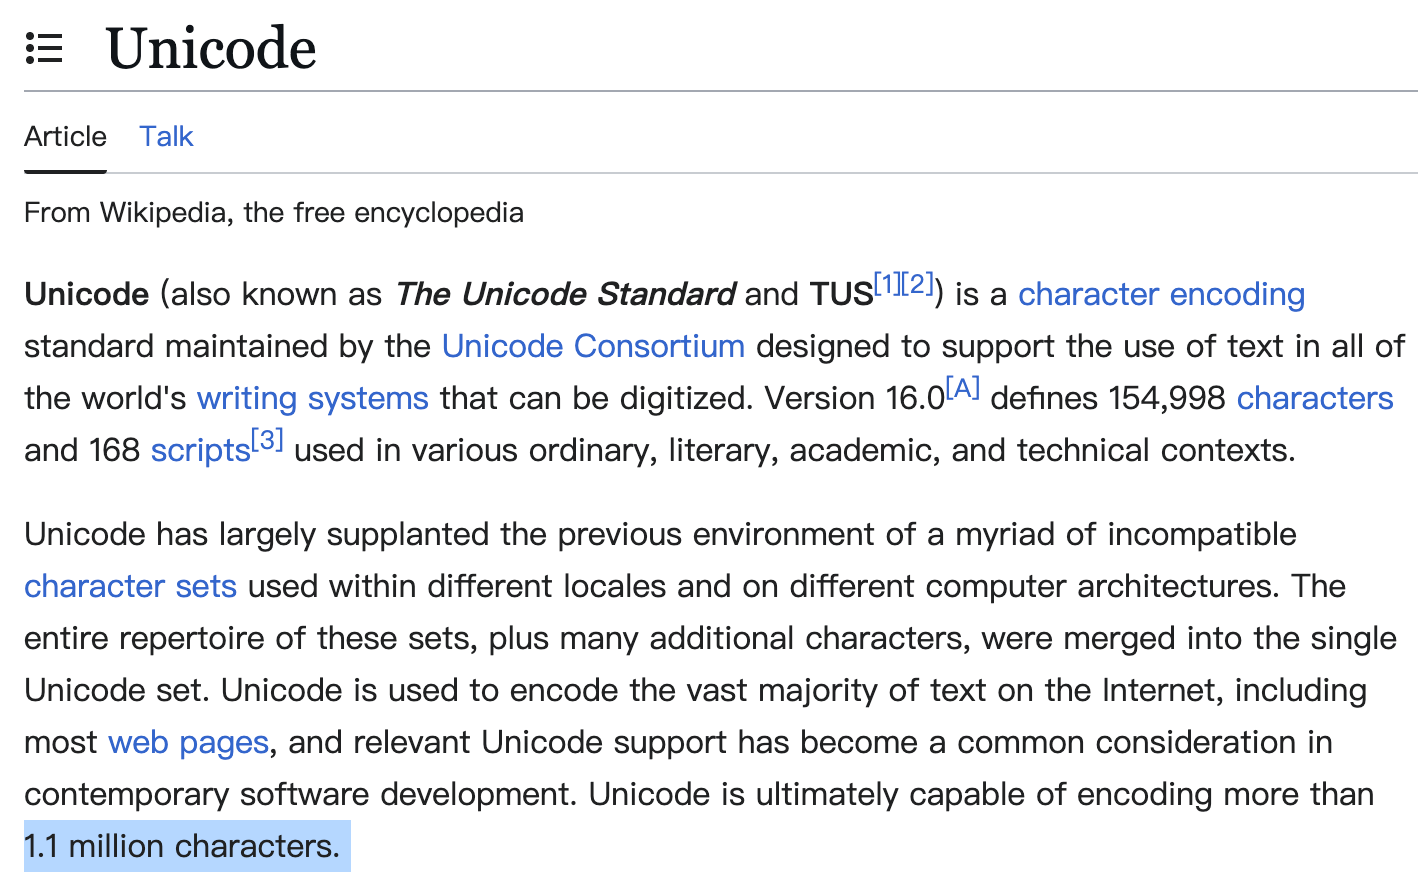
Unicode是计算机领域字符编码的业界标准,它为每种语言中的每个字符设定了统一且唯一的二进制编码。根据 Wikipedia,它的 16.0 版本含有 154,998 个字符。
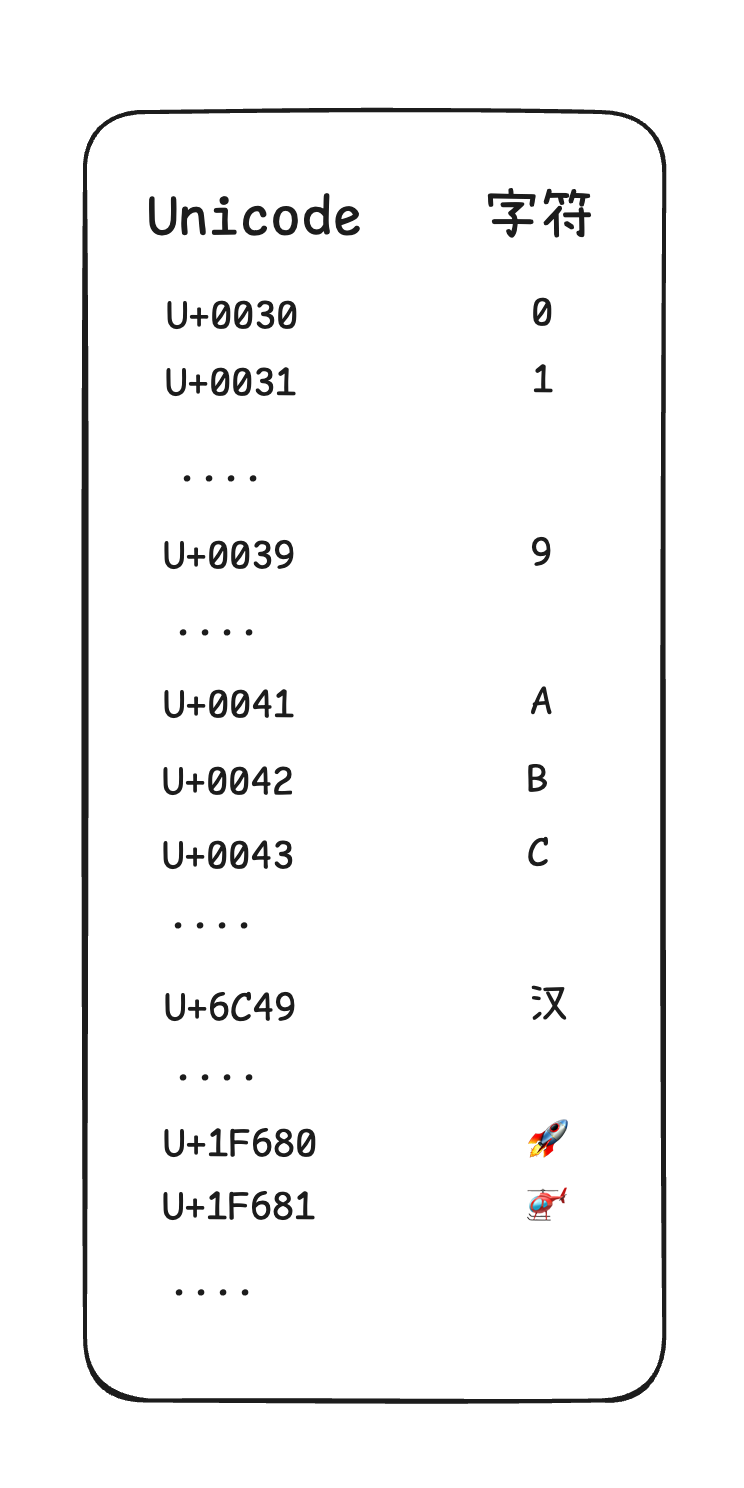
其实理解起来很简单,他就是一个超大的 map,含有 154,998 个条目,其中每个条目的 key 是一个数字,value 就是实际对应的字符。
其中,这里的 key 就叫码点(Code Point)。
通过一个码点,也就是 UnicodeMap[key] ,就可以唯一定位到一个字符。
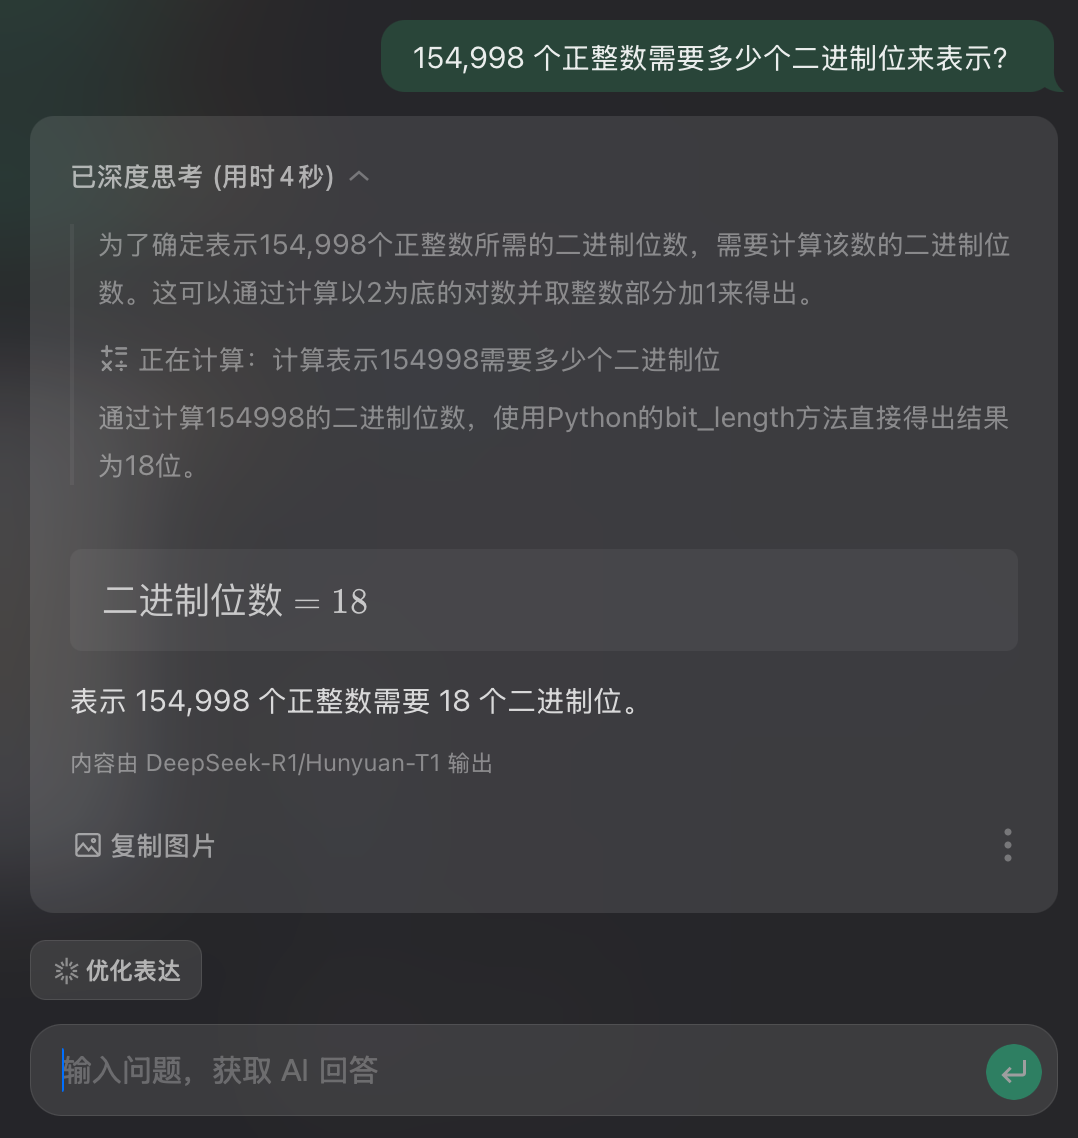
有兴趣的小伙伴可能已经开始抄起计算器算了,这个 map 的 key 数至少有 154,998 个,那这个 key 需要多少个二进制位来表示?
我们可以自己算,也可以用微信输入法问 AI 算,反正最后是需要 18 个二进制位。
但其实 Unicode 标准预留的位置比这个多,它的码点取值范围是从 0x0 到 0x10FFFF,这个范围可以容纳 110 万个左右的字符。
所以,这就是为什么 Wikipedia 称 Unicode 可以存 110w+ 字符。
到这里又有人要问了,那按你这么说,总共加起来都需要 24 位了,也就是 3 个字节,难道计算机上存一个字符需要 3 个字节吗?这跟我学过的计算机知识不一样啊,char 类型不是一个字节吗?
随便拍脑袋一想,那么大的 map,最前面的那些 key,肯定是很短的,就不能压缩一下吗?
没错,因为有些字符的码点很短,我们没必要浪费空间,这就是我们日常熟知的 UTF-8, UTF-16, UTF-32 等编码方式的由来。
- UTF-8:一种变长编码方式,使用 1 到 4 个字节来表示不同的字符。它具备良好的向后兼容性,能与 ASCII 编码无缝衔接,是网页和文件存储领域应用最为广泛的编码标准。
- UTF-16:同样属于变长编码,采用 2 个或 4 个字节来表示字符。它主要应用于 Windows、Java 以及 JavaScript 等系统和技术中。
- UTF-32:这是一种定长编码,每个字符固定占用 4 个字节。其优势在于编码规则简单直接,但会占用较多的存储空间。
UTF-32 我们先不讨论,我们可以看到,UTF-8 和 UTF-16 都是变长的,此时假设你要用一个数组来表示一个字符序列,你要怎么办呢?
如果你使用 JavaScript/Python 这类动态类型语言,你就会说,这还不简单?有手就行。
如果你是用 C 这类静态类型语言,就要开始挠头了。简单搞个 char[] 又不行,碰到 1 字节以上的就放不下,搞多点用个什么 uint32_t[] 又浪费空间。
那其实也比较容易想到一种办法,我取可能的最短字节数作为每个元素的大小,在此编码方式下,其他支持的字节数,都是这个基本单位的倍数,就可以了。
例如 UTF-8 最短的单元是 1 字节,我就用 char[],当他需要 2 字节、3 字节的时候,就占 2 个、3 个元素就好了。
UTF-16 最短的单元是 2 字节,我就用 uint16_t[],当他需要 4 字节的时候,就占 2 个元素。
这就是 码元(CodeUnit) 概念的由来。
有了码元的概念,无论我用什么编码方式,我的字符数组都是 CodeUnit[] 就 OK 了。
UTF-16
回到本文重点,我们主要讨论在 JS 下如何正确处理 emoji,那么 JavaScript 的 String 采用的是什么字符编码呢?是 UTF-16.
我们刚刚有说到,对于 UTF-16,它的码元长度是 2 字节,也就是 16 位,我们那个庞大的 Unicode 字符 map 里,哪些 key 可以只用一个 UTF-16 码元来存呢?
答案是从 0x0 到 0xFFFF 范围的 key。比这更大的 key,就需要两个码元才能放得下了。
这个有点类似于给一个 map 人为分段,Unicode 也自己分了几个段,这就是 基本多文种平面(Basic Multilingual Plane, BMP) 和 辅助平面 的由来。
其实 Unicode 把他分成了很多段,但为了方便讨论,一般都只划分两段:
- 基本平面:
0x0到0xFFFF,一共0x10000个字符,涵盖了大量常用字符。 - 辅助平面:
0x10000到0x10FFFF,一共0xFFFFF个字符,用于容纳相对不那么常用的字符,大部分 emoji 在这个段上。
我们刚说了,辅助平面上,一共有 0xFFFFF 个字符,假设用二进制表示需要 20 位才够,一个 UTF-16 码元只有 16 位,是放不下的。
那就用两个码元咯,一拍脑袋就想到,你不是说 20 位嘛,我拆成高 10 位和低 10 位,分别放在两个码元里,不就行了?
好的,我们引出了另一个问题:那如果你是那个写 UTF-16 字符序列解析器的人,你要怎么写呢?遇到一个码元,你怎么知道它自己就是完整的,还是要连着它后面那个一起看?
所以,我们肯定有一些二进制位是用来做标记的,告诉解析器,遇到我的时候,请你再往后看一位。
这就是 基本平面内 UTF-16 保留区 的由来。

Unicode 基本平面为 UTF-16 保留了两个区段,于是人们发明了一种叫 代理对(Surrogate Pairs) 的东西,用来把一个辅助平面的码点的高 10 位和低 10 位分开,然后塞到两个码元里,并且恰好位于这个区段。
代理对
具体是如何操作呢?简单来说,先减去 0x10000,得到的就是在辅助平面内的偏移量,这个偏移量是 20 位。
此时要把 20 位的东西塞进代理对,取高 10 位加上 0xD800,作为第一个码元(称为高代理, high surrogate);再取低 10 位加上 0xDC00,作为第二个码元(成为低代理,low surrogate),就 OK 了。
文字版步骤:
- 先将码点减去0x10000,得到一个0~0xFFFFF范围内的值(最多20位)
- 高10位加上0xD800得到高位代理值(范围0xD800~0xDBFF)
- 低10位加上0xDC00得到低位代理值(范围0xDC00~0xDFFF)
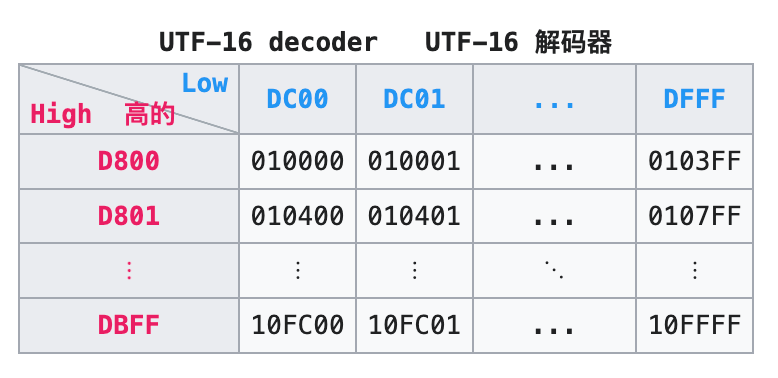
所以一个代理对可以表示为:(高位代理, 低位代理),两者结合计算出实际的码点值。
代码版:
用代码来讲可能更清晰一些:
const HIGH_SURROGATE_START = 0xd800
const LOW_SURROGATE_START = 0xdc00

function surrogatePairFromCodePoint(codePoint: number): string {
  // 验证输入是否为有效码点 (U+0000 至 U+10FFFF)
  if (!Number.isInteger(codePoint) ||
      codePoint < 0 ||
      codePoint > 0x10FFFF) {
    throw new RangeError('Invalid code point');
  }

  // 基本多文种平面 (BMP) 字符无需使用代理对
  if (codePoint <= 0xFFFF) {
    return String.fromCodePoint(codePoint);
  }

  // 计算高代理和低代理值
  const offset = codePoint - 0x10000;
  const high = HIGH_SURROGATE_START + (offset >> 10);
  const low = LOW_SURROGATE_START + (offset & 0x3FF);

  // 转换为 UTF-16 代理对字符串
  return String.fromCharCode(high, low);
}
反过来,如何把代理对转换回一个码点?其实就是执行上面的逆操作:第一个码元减去 0xD800 再左移十位,加上第二个码元减去 0xDC00的结果,在加上 0x10000,具体可以看下面代码
const HIGH_SURROGATE_START = 0xd800
const LOW_SURROGATE_START = 0xdc00

function codePointFromSurrogatePair (pair: string): string {
  const highOffset = pair.charCodeAt(0) - HIGH_SURROGATE_START
  const lowOffset = pair.charCodeAt(1) - LOW_SURROGATE_START
  return (highOffset << 10) + lowOffset + 0x10000
}
讲到这里,我们已经解决了所有 Unicode 在 UTF-16 编码方式下应该如何编码的问题。这和 emoji 又有什么关系呢?
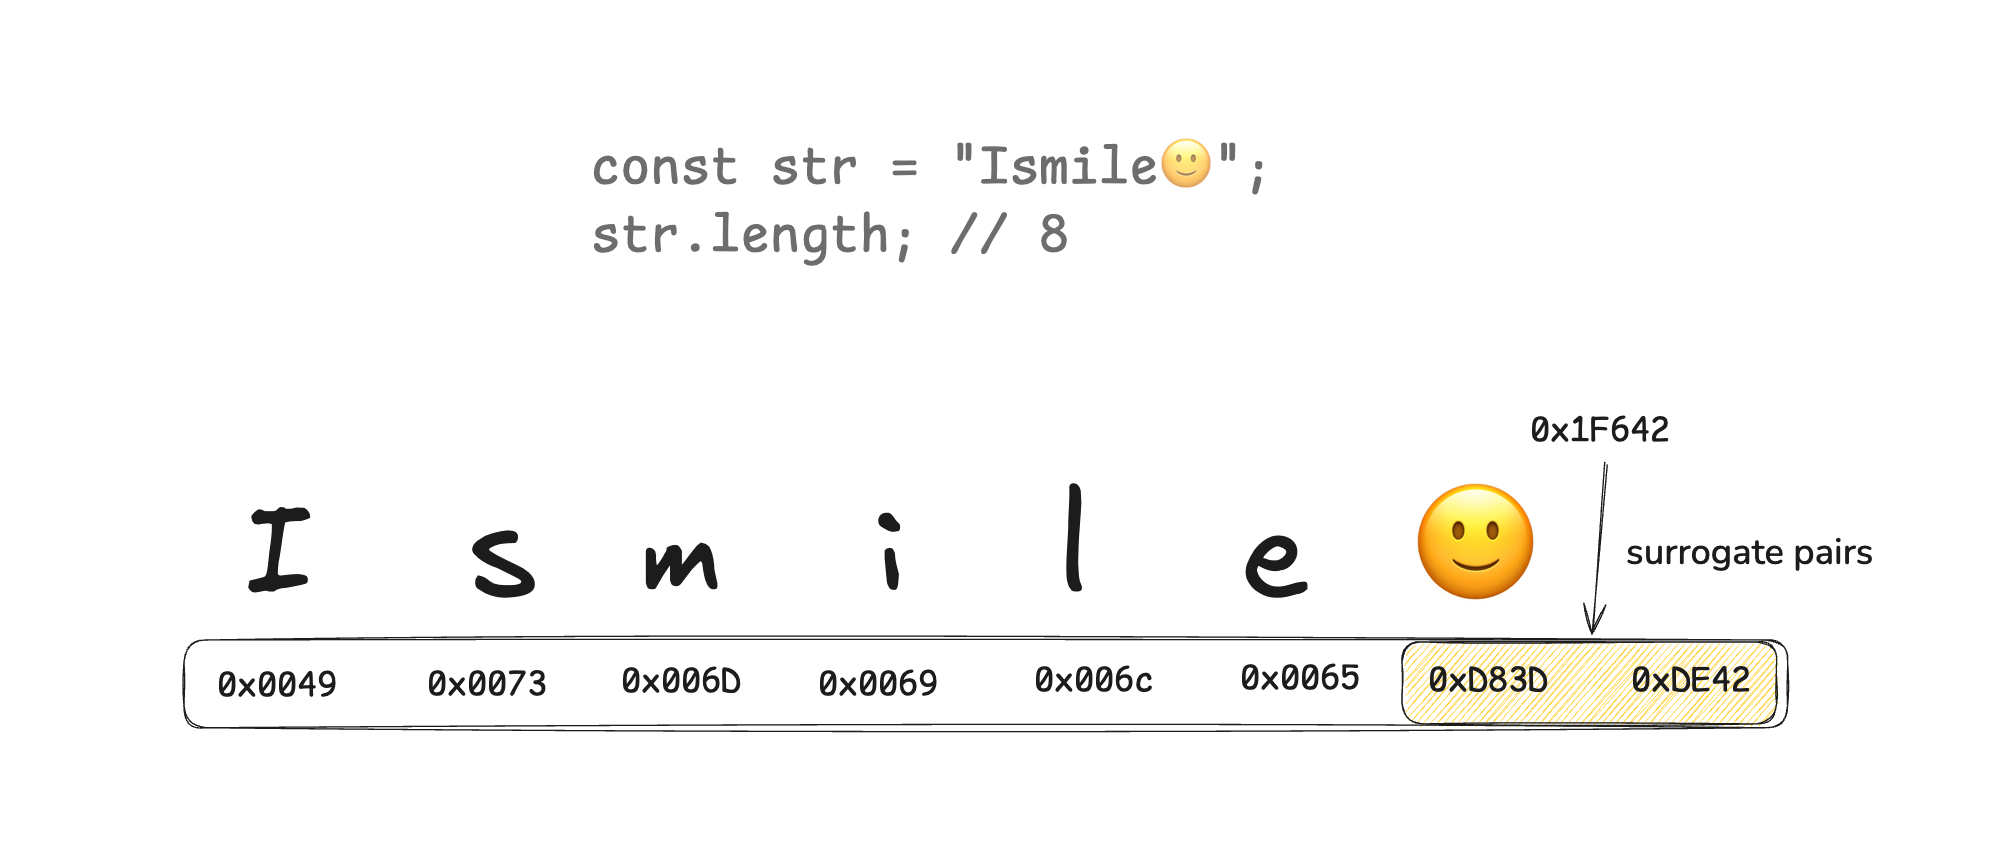
其实我们已经可以回答开篇的其中一个问题,为什么含有 emoji 字符串的 length 看起来不太对劲。
以笑脸😀为例,它的码点是 0x1F600,位于辅助平面,它的代理对表示为 0xD83D 0xDE00,占用两个码元。根据 MDN 文档,String 的 length 属性返回的是 UTF-16 码元的个数。
The length data property of a String value contains the length of the string in UTF-16 code units.
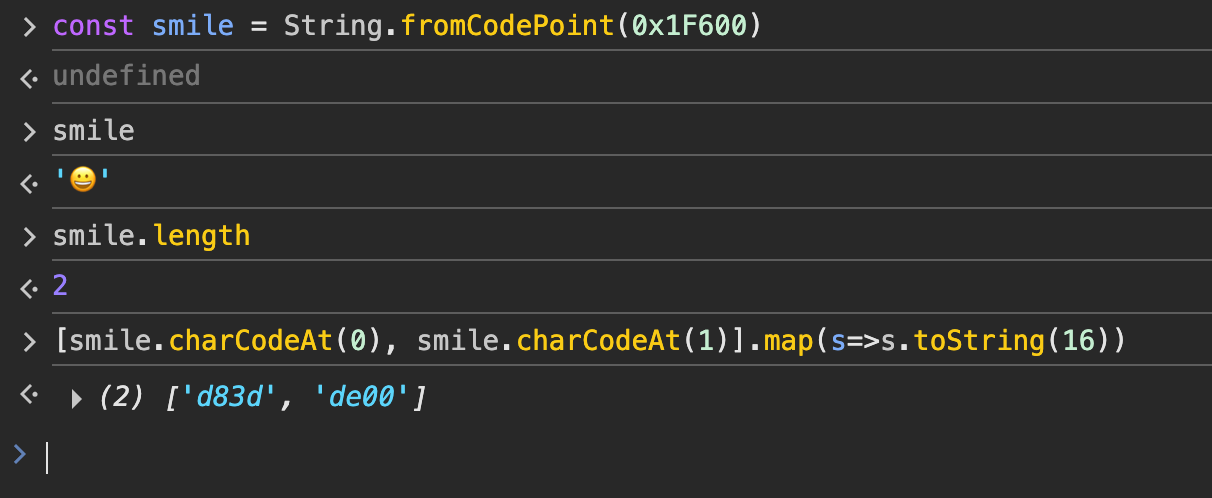
有的人又要问了,2 个码元我可以理解啊,这种 11 的是什么玩意??
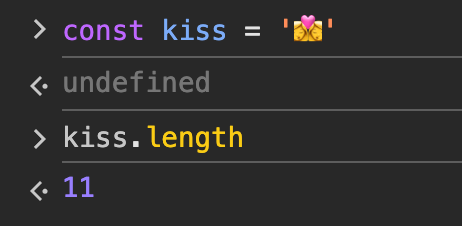
别急,JS 又不会骗你,说明人家要 11 个码元才能表示出来。
接下来,我会列举一下常见的 emoji 组合模式。
2 常见的 emoji 类型及其组合模式
其实 emoji 并没有那么简单,里面含有很多组合的逻辑。
最常见的单码点模式
这里主要有最开始的一波基础 emoji 表情,例如:
| Emoji | Unicode 码点 | UTF-16 代理对 |
|---|---|---|
| 😀 | U+1F600 | 0xD83D,0xDE00 |
| 🤪 | U+1F92A | 0xD83E,0xDD2A |
| 🦊 | U+1F98A | 0xD83E,0xDD8A |
| 🚀 | U+1F680 | 0xD83D,0xDE80 |
| … | … | … |
// 如果你想在浏览器玩玩,这里提供了一些示例
String.fromCodePoint(0x1F98A); // 🦊
String.fromCharCode(0xD83E,0xDD8A); // 🦊
'🦊'.charCodeAt(0).toString(16); // D83E
'🦊'.charCodeAt(1).toString(16); // DD8A
'🦊'.codePointAt(0).toString(16); // 1F98A
注:这里 U+1F600 和 0x1F600 只是两种习惯的表示方法,表示的都是 Unicode 码点
肤色修饰模式
大家都应该使用过,苹果输入法/微信输入法,都可以选择 emoji 的肤色
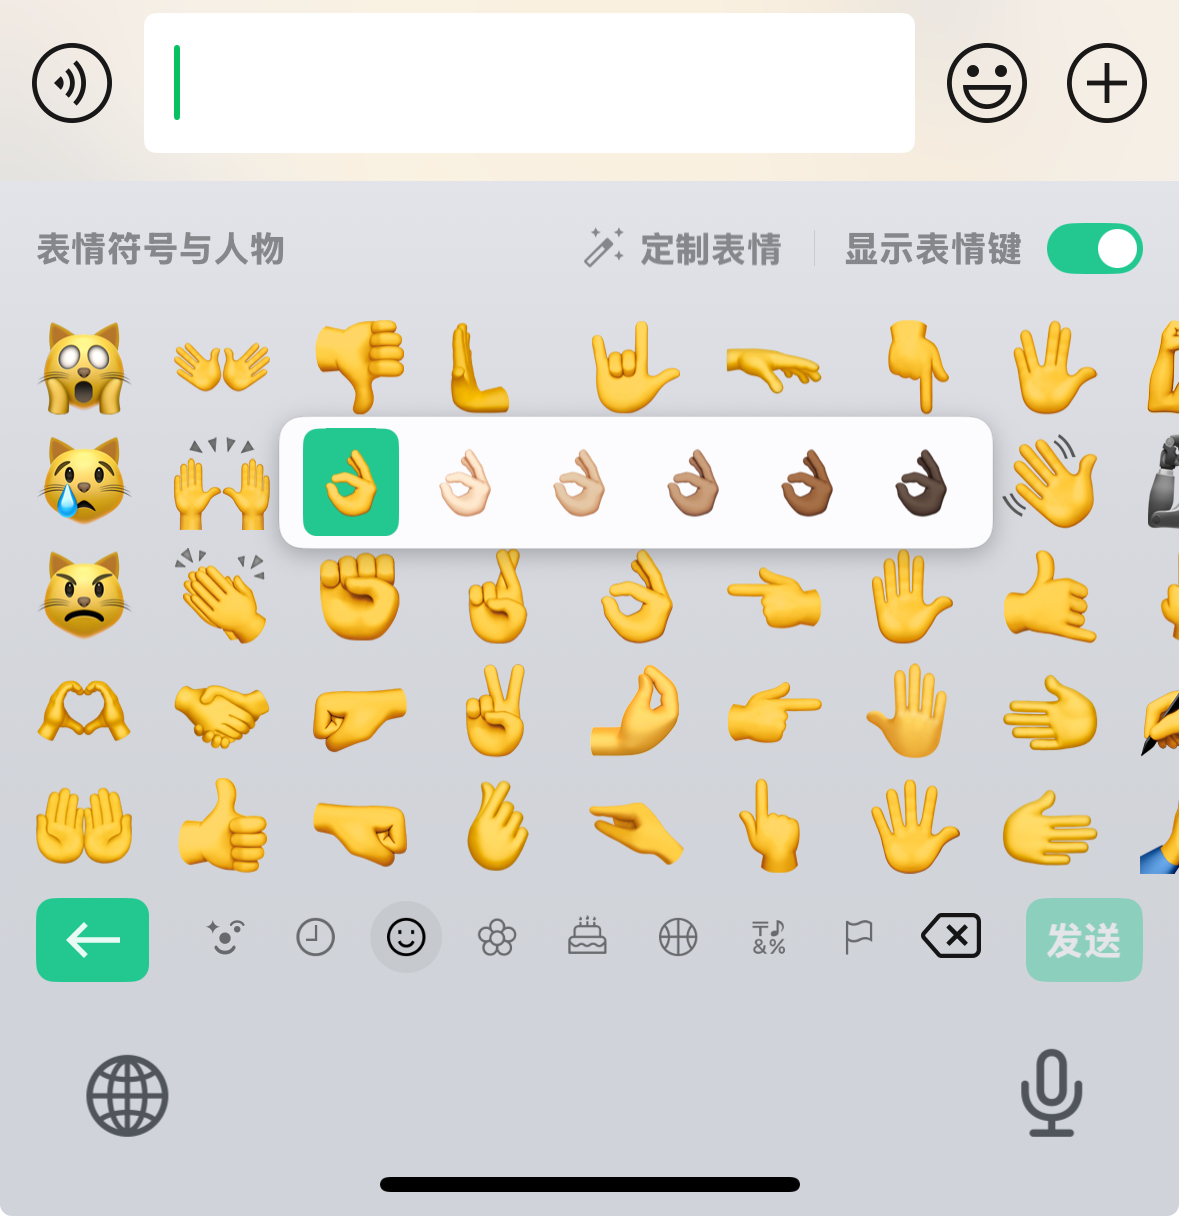
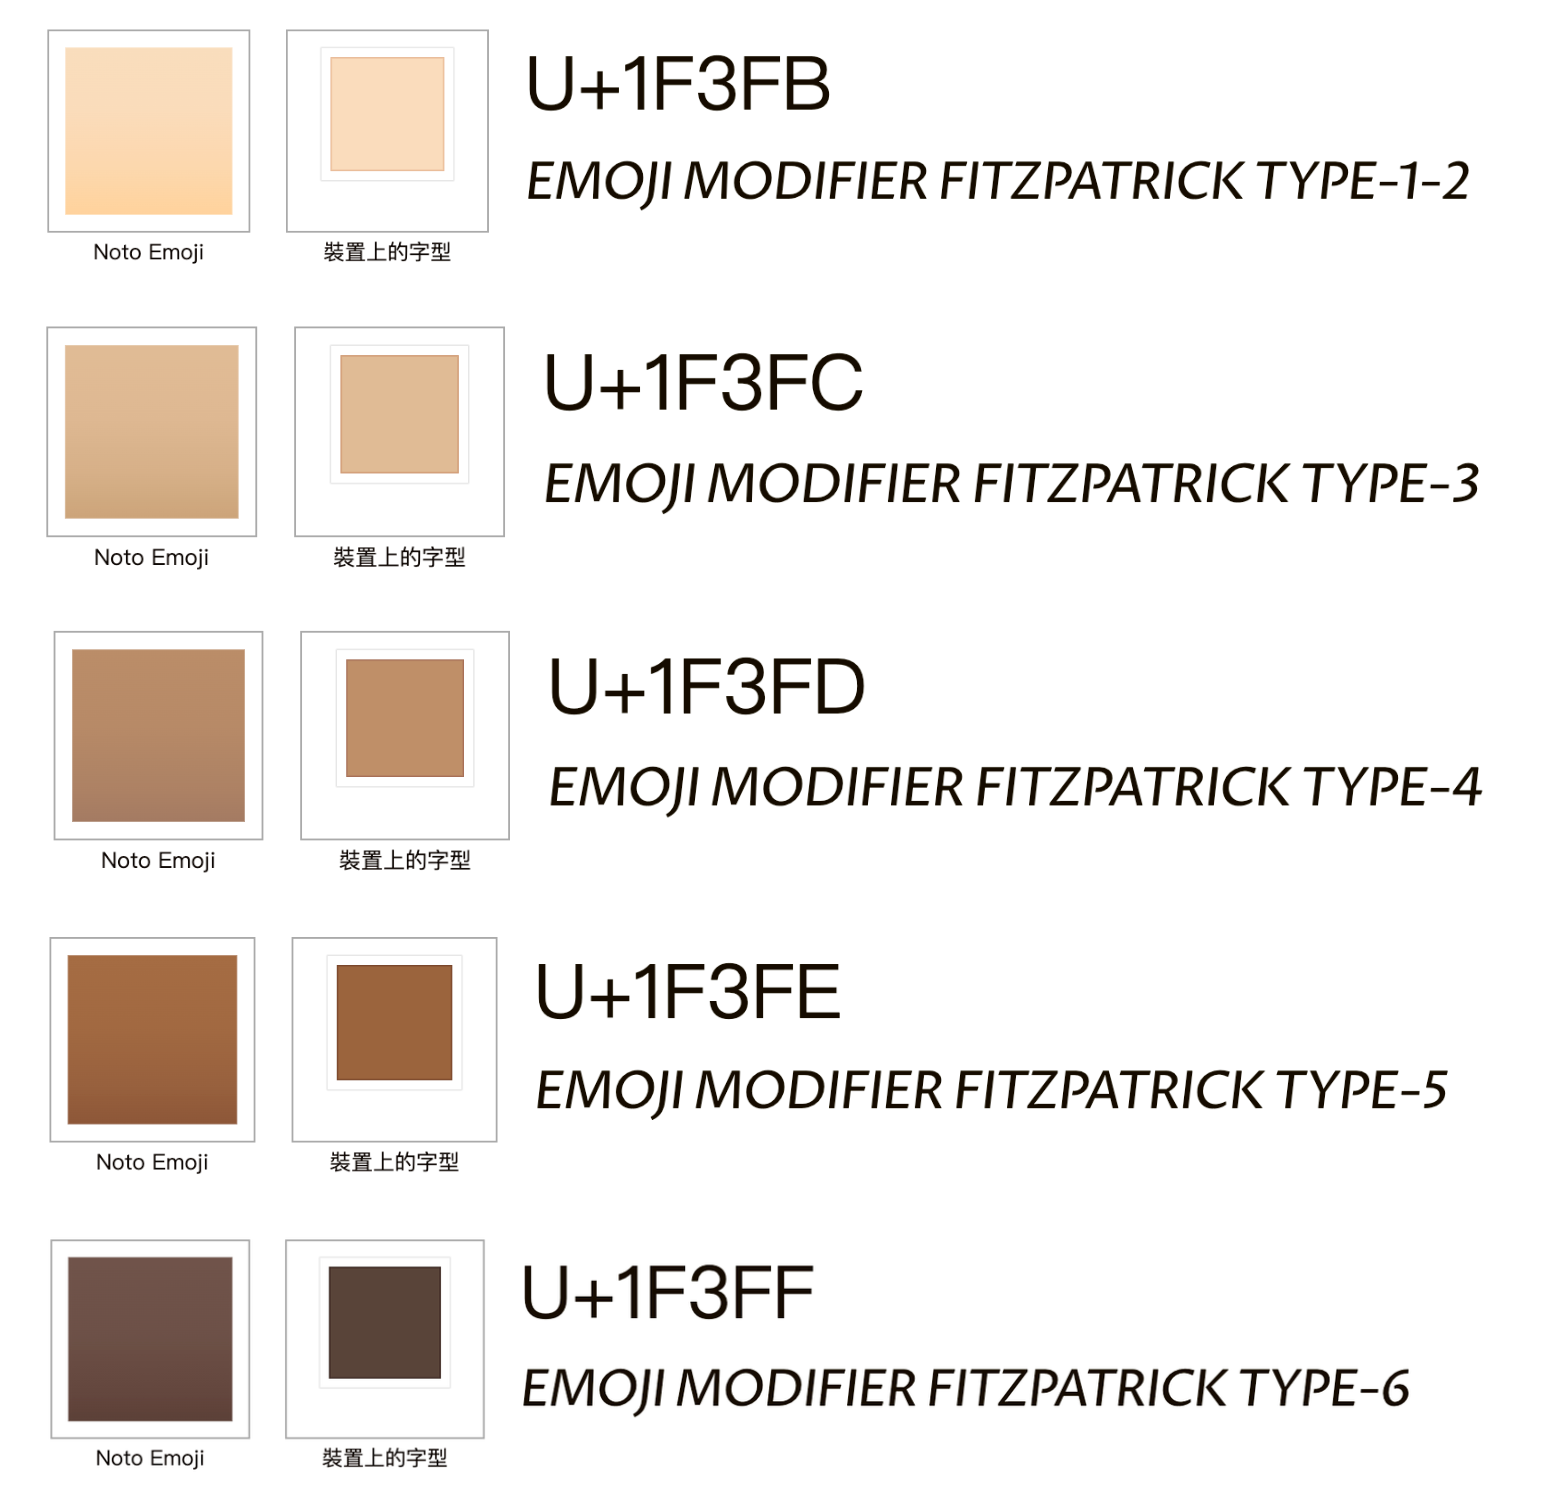
肤色是怎么实现的呢?有种叫做「肤色修饰器」的东西,有好几个类型,把他加在人物/手势 emoji 码元的后面,显示出来就会变成不同的肤色。
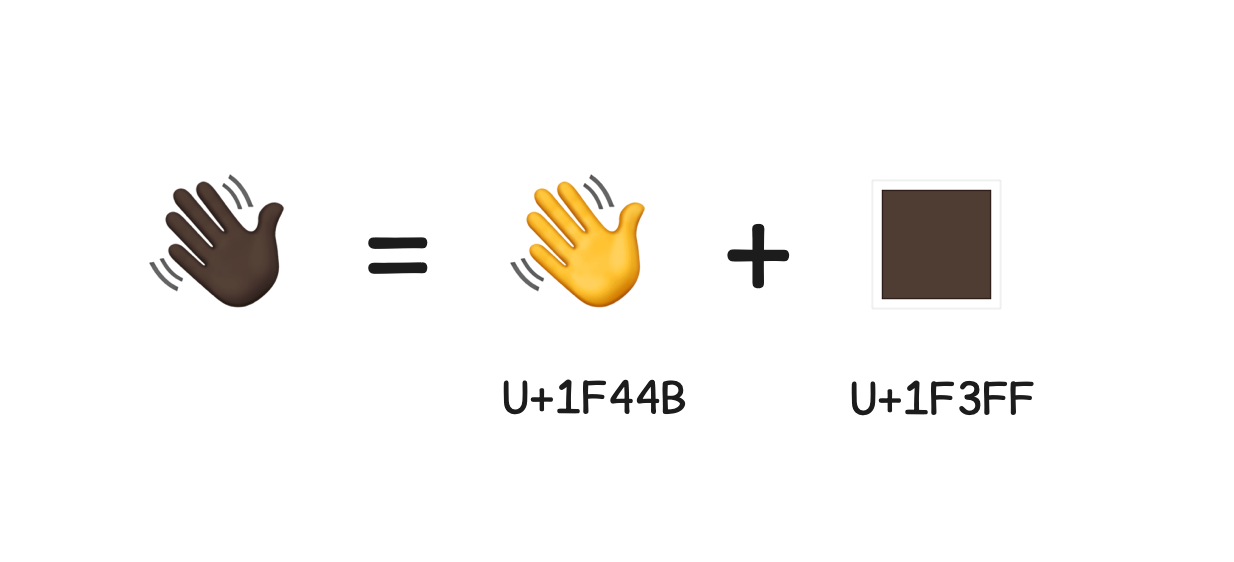
例如,“👋”(你好)这个 emoji,通过添加肤色修饰器,可以变成不同颜色的手,如 👋🏻👋🏽👋🏾👋🏿
我们找了一下,发现👋这个 emoji 的码点是:U+1F44B
其他颜色的手都是 2 个码点,如下图:
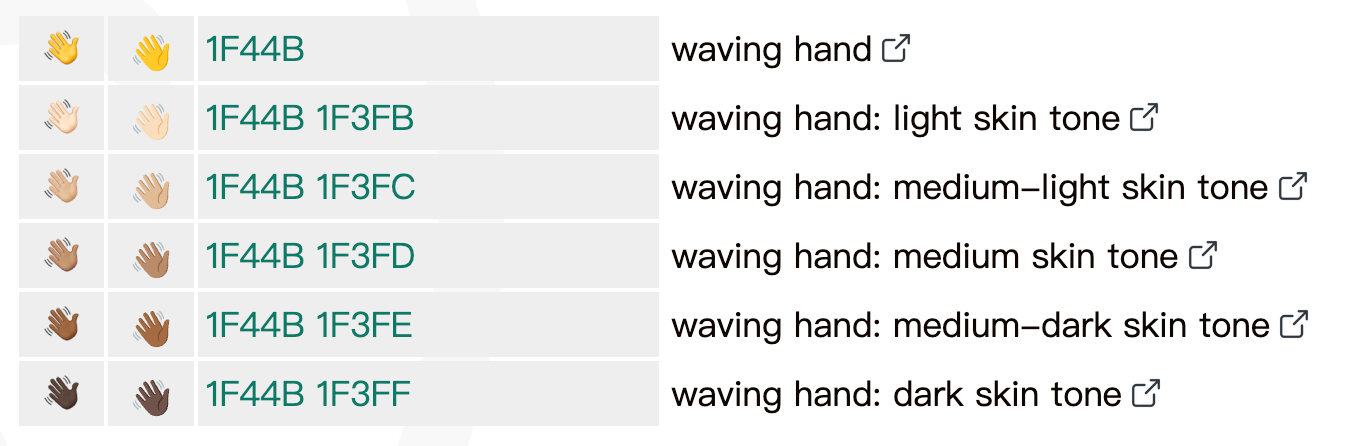
我们发现,在基础 emoji 后面加上肤色修饰器,就可以改变基础 emoji 的肤色。
主要的肤色修饰器有这么几种,如果不写修饰器,就是默认的黄色。
变体选择器
在某些奇怪的应用/跨平台消息发送场景中,你是否遇到过这种情况?本想发给女朋友的爱心♥️,发过去之后变成了黑色的♥,这是为什么呢?
此时我们查看一下他们的码点分别是什么:
| 字符 | 码点 |
|---|---|
| ♥ | U+2665 |
| ♥️ | U+2665 U+FE0F |
我们发现,黑色的爱心其实是一个早就存在的字符,看它是 U+2665 就知道它位于基本平面。
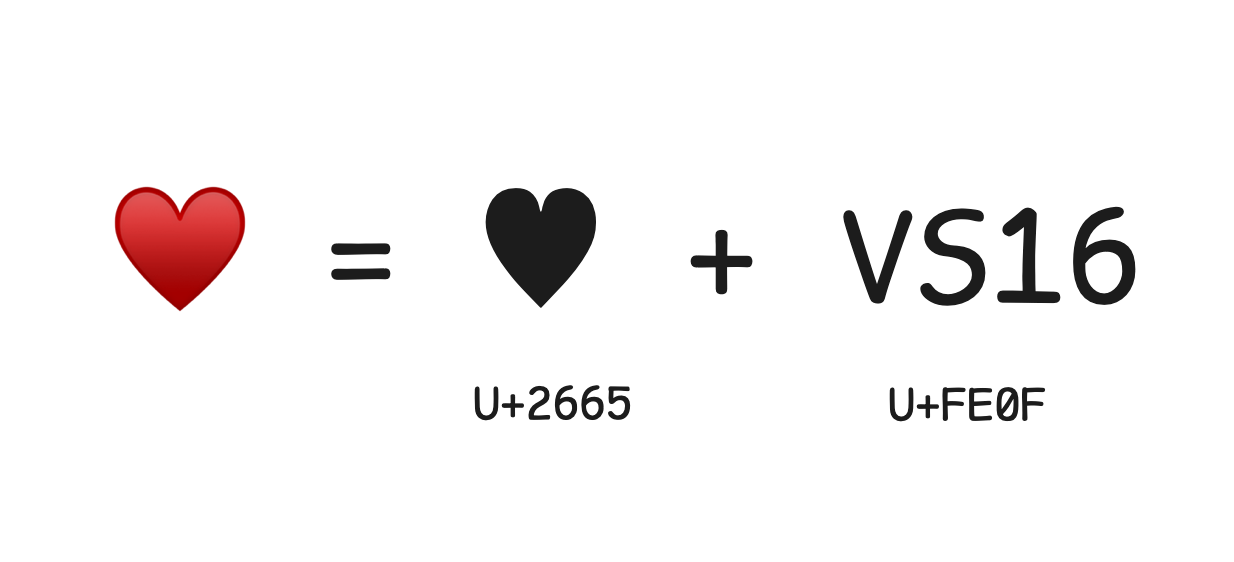
估计后来有了红心 emoji 之后,才通过在它后面加一个 U+FE0F 来表示这个应该以彩色形式显示。我估计这个应该是历史的尘埃(产物)了,下面附上一些来自其他资料的解释:
随着计算机技术的发展,人们对字符显示的多样性需求增加。同一字符可能有多种显示样式,例如表情符号可能希望以彩色图像形式显示,也可能希望以单色文本形式显示。为了满足这种需求,Unicode 引入了变体选择器机制,通过在基本字符后添加特定的变体选择器,来告知软件以何种样式呈现字符。
Unicode 的基本平面中,0xFE00 到 0xFE0F 范围的字符,都属于变体选择器(Variation Selector),其中 U+FE0F 被指定用来表示一个基本图案应该以彩色 emoji 方式来显示。
一般 emoji 风格呈现的字符是彩色的,而文本风格渲染的字符是黑白的。为了明确指定 emoji 字符的显示风格,U+FE0E 被用于标明该文字应显示为文本样式,U+FE0F 则用于标明该文字应显示为 emoji 样式。
还有哪些使用变体选择器的例子呢?
| 基础字符 | 码点 | 带变体选择器 | 码点 |
|---|---|---|---|
| ☀ | U+2600 | ☀️ | U+2600 U+FE0F |
| ♠ | U+2660 | ♠️️ | U+2660 U+FE0F |
| ⬆ | U+2B06 | ⬆️️️ | U+2B06 U+FE0F |
| ☑ | U+2611 | ️ ☑️️️ | U+2611 U+FE0F |
按键组合模式
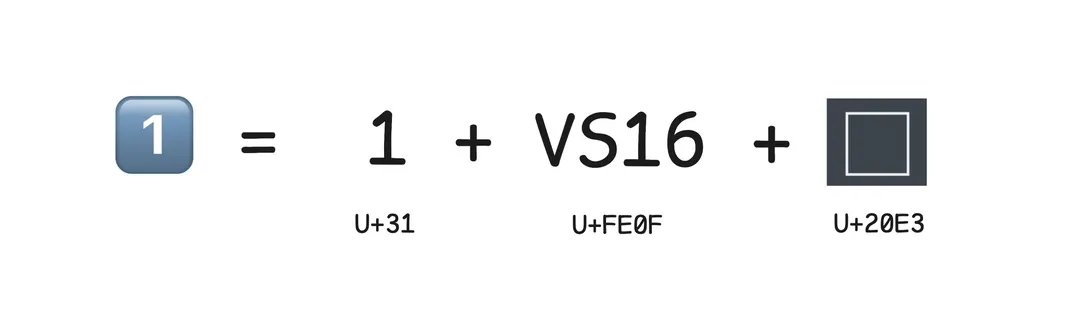
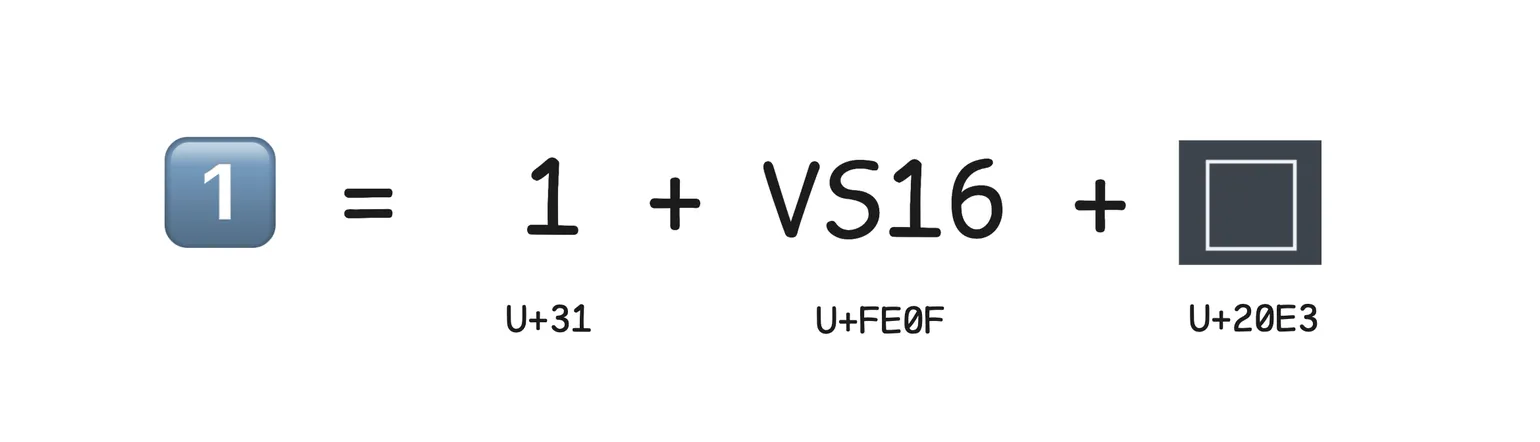
我们平时经常会用到的 1️⃣ 2️⃣ 3️⃣ 这类按键 emoji 就属于这个系列,它是由一个基础码点+变体选择器+框选码点来组成的。
国旗组合模式
国旗 emoji 的玩法稍微特殊一点,但规则也比较简单:通常是由两个区域指示符号字母组成,比如“🇨🇳”代表中国国旗,其实他是 C + N 两面旗(两个码点)组合起来表示的。
| Part 1 | 码点 | Part 2 | 码点 | 组合 | 码点 |
|---|---|---|---|---|---|
| 🇨 | U+1F1E8 | 🇳 | U+1F1F3 | 🇨🇳 | U+1F1E8 U+1F1F3 |
| 🇯 | U+1F1EF | 🇵 | U+1F1F5 | 🇯🇵 | U+1F1EF U+1F1F5 |
| 🇺 | U+1F1FA | 🇸 | U+1F1F8 | 🇺🇸 | U+1F1FA U+1F1F8 |
| 🇬 | U+1F1EC | 🇧 | U+1F1E7 | 🇬🇧 | U+1F1EC U+1F1E7 |
| 🇧 | U+1F1E7 | 🇷 | U+1F1F7 | 🇧🇷 | U+1F1E7 U+1F1F7 |
连接组合模式
上面主要讲的几种都可以理解为「修饰器」,emoji 还有一种更大的扩充自身的方式,它允许多个独立的 emoji 连接起来表达更复杂的概念,这就是通过零宽连接符(Zero Width Joiner, ZWJ) 实现的组合模式。
零宽连接符的码点是 U+200D,顾名思义,它是一个”零宽度”的字符,本身不显示,但能将前后的 emoji 粘合在一起,形成一个新的视觉单元。
为了方便表述,下面统一将零宽连接符简称为 ZWJ
职业组合
最简单的例子是职业 emoji。例如👨🔬(男科学家)是由👨(男人)和🔬(显微镜)组合:
| 部分 | 描述 | 码点 |
|---|---|---|
| 👨 | 男人 | U+1F468 |
| | 零宽连接符 | U+200D |
| 🔬 | 显微镜 | U+1F52C |
其他例子:
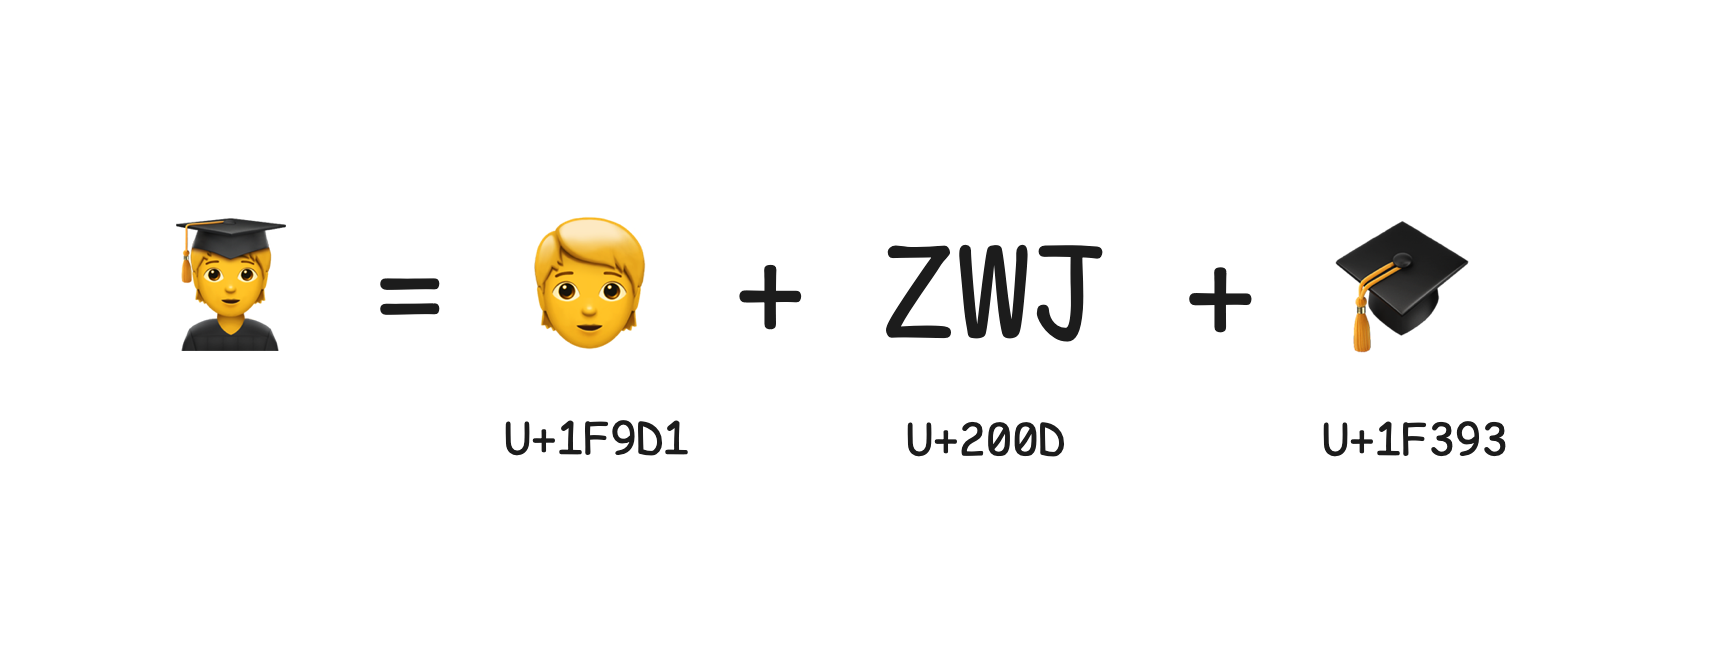
👨🔬 = 👨 + ZWJ + 🔬 // 科学家
🧑💻 = 🧑 + ZWJ + 💻 // 程序员动作 + 性别组合
一些emoji会结合性别符号,如“♂️”(男性符号)和“♀️”(女性符号),与其他emoji组合形成新的表意符号。例如,🙋♀️(女性举手)就是将 🙋(开心举手的人)与♀ 通过 ZWJ 组合在一起。通过 emojipedia 我们可以看到它的码点序列:
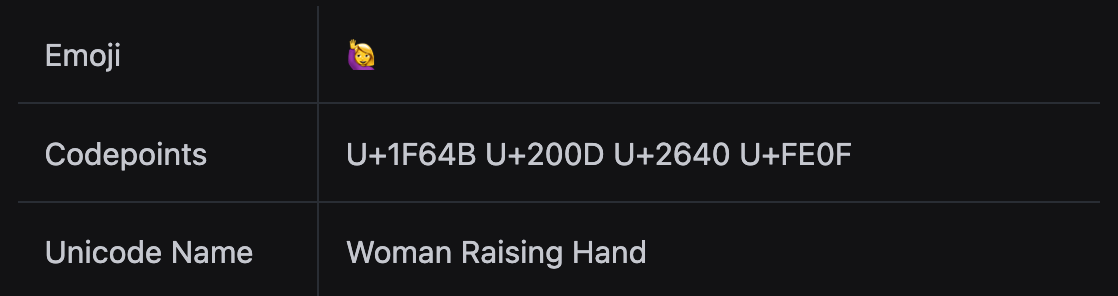
🙋♀️ = 🙋 + ZWJ + ♀ + 0xFE0F // 女性举手家庭组合
例如👨👩👧👦(一家四口)实际上是由4个独立的emoji通过3个零宽连接符连接而成:
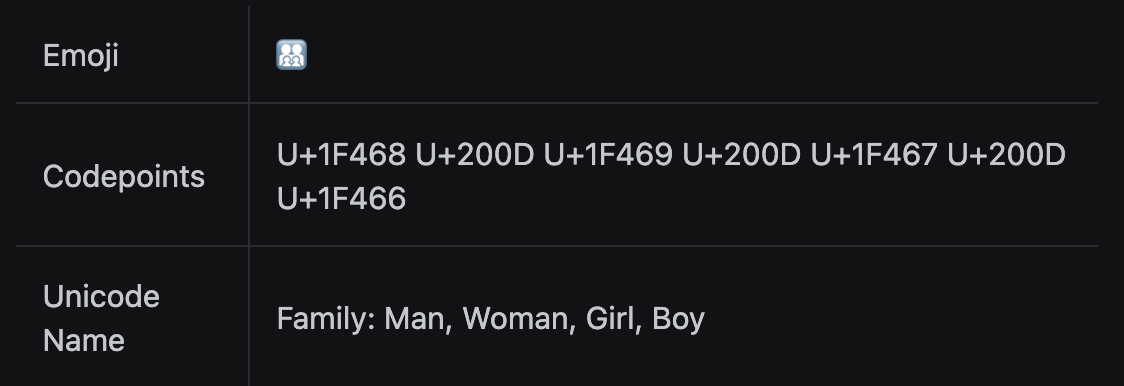
👨👩👧👦 = 👨 + ZWJ + 👩 + ZWJ + 👧 + ZWJ + 👦我们来分析一下它的码点构成:
| 部分 | 描述 | 码点 |
|---|---|---|
| 👨 | 男人 | U+1F468 |
| | ZWJ | U+200D |
| 👩 | 女人 | U+1F469 |
| | ZWJ | U+200D |
| 👧 | 女孩 | U+1F467 |
| | ZWJ | U+200D |
| 👦 | 男孩 | U+1F466 |
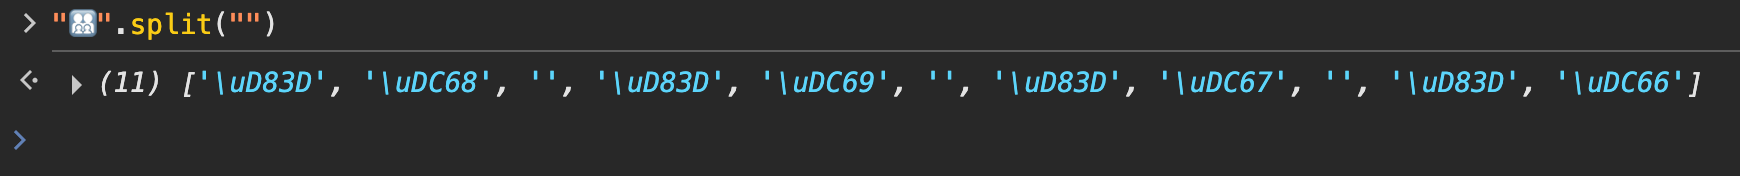
到这里,我们已经可以回答上一 Part 提出的问题:为什么 "👨👩👧👦".length = 11
因为一个看似简单的家庭 emoji 实际上由 7 个码点组成,其中零宽连接符 3 个(每个占 1 个码元),另外的人物都在辅助平面,需要用两个码元来表示,所以最后得到的长度是 8 + 3 = 11。
复杂组合模式:肤色+性别+职业+连接
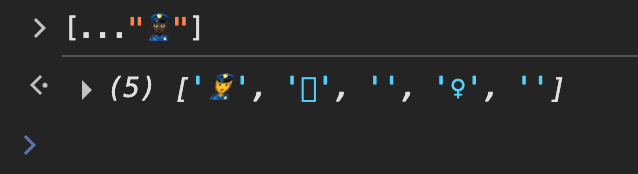
上面讲过的所有模式,混在一起,就是复杂组合模式。例如,深色皮肤女警察👮🏿♀️是由以下元素组合而成:
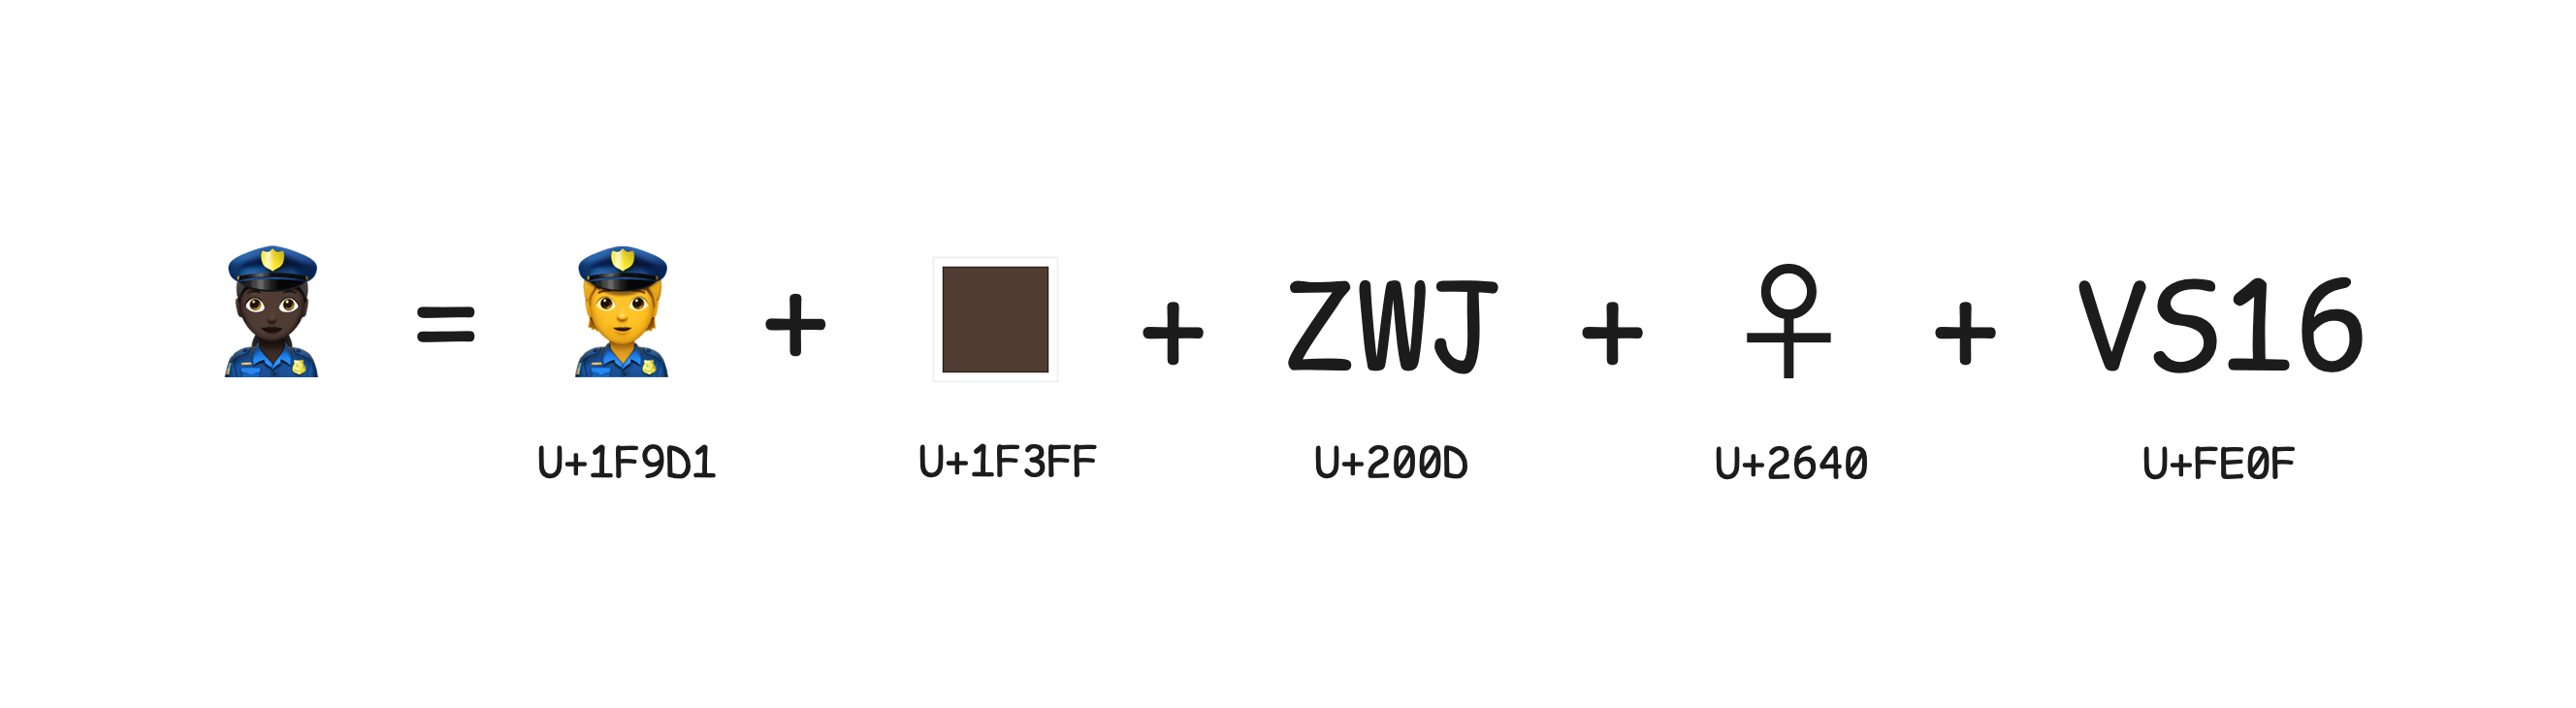
具体分解为:
| 部分 | 描述 | 码点 |
|---|---|---|
| 👮 | 警察 | U+1F46E |
| 🏿 | 深色肤色修饰符 | U+1F3FF |
| | 零宽连接符 | U+200D |
| ♀ | 女性符号 | U+2640 |
| ️ | 变体选择器 | U+FE0F |
其实我们这里可以做个实验,我猜 spread 运算符应该是特殊处理了代理对,但是并没能处理好组合的情况。
其他有趣的组合
彩虹旗🏳️🌈:白旗与彩虹的组合
🏳️🌈 = 🏳️ + U+200D + 🌈带着爱心飞的箭头💘:爱心与箭头的组合
💘 = ❤️ + U+200D + 🏹女人和女人亲嘴
👩❤️💋👩 = 👩 + U+200D + ❤️ + U+200D + 💋 + U+200D + 👩两个深色皮肤女人亲嘴
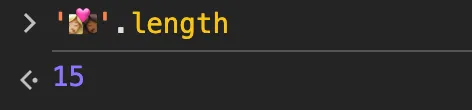
👩🏽❤️💋👩🏽 U+1F469 U+1F3FD U+200D U+2764 U+FE0F U+200D U+1F48B U+200D U+1F469 U+1F3FD两边肤色不一样
👩🏼❤️💋👩🏾' U+1F469 U+1F3FC U+200D U+2764 U+FE0F U+200D U+1F48B U+200D U+1F469 U+1F3FE有兴趣的朋友可以算算最后这个不同肤色女人亲嘴的 emoji 的长度是多少,哈哈。
这么多组合,怎么处理呢?
上面说的这些模式,极大地丰富了 emoji 的表现力,但也给字符串处理带来了挑战。当你尝试对含 emoji 的字符串进行 split 拆分、计算长度或取子串操作时,如果不考虑这些特殊结构,容易导致一些问题:
- 先拆开,然后做逐字 fade-in 动画,会出现问号乱码
- 如果字符串会在后台和前端之间流转,两段计算的长度可能对不上
- 在需要统计字数的场景,直接使用 length 计算,也不准确
例如,我们尝试 split 一个家庭 emoji 会产生什么,大家应该心里有数了:
有人说:我用扩展运算符不行吗?我们看看:
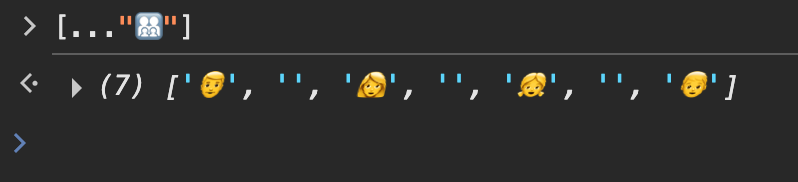
不得不说,这个还是比 split 拆分得好一些,只不过把人家一家人拆散了 (doge
其实,因为 JS 的字符串操作函数(如String.prototype.charAt()或String.prototype.substring())还有 length 属性都是基于 UTF-16 码元的,所以在面对 emoji 和其他非基本平面字符时,都会有这种问题。
所以,我们需要一个成熟的方案来帮我们「正确地识别每个 Unicode 单元」。
3 runes.js 源码解读
runes 是一个专门用于处理含有 emoji 和其他 Unicode 字符的 JavaScript 字符串分割库。在 JavaScript 中,默认的String.split('')方法无法正确处理 emoji 和其他非 BMP(Basic Multilingual Plane) 字符,runes 库解决了这个问题。
这是一个比较简单的工具库,只有一个文件,导出两个函数 runes 和 substr,它在处理emoji相关操作时,紧密结合了前面提到的Unicode原理和编码知识,为前端开发中处理emoji字符串提供了可靠的解决方案。
先看效果:
const runes = require('runes')
// Standard String.split
'♥️'.split('') => ['♥', '️']
'Emoji 🤖'.split('') => ['E', 'm', 'o', 'j', 'i', ' ', '�', '�']
'👩👩👧👦'.split('') => ['�', '�', '', '�', '�', '', '�', '�', '', '�', '�']
// ES6 string iterator
[...'♥️'] => [ '♥', '️' ]
[...'Emoji 🤖'] => [ 'E', 'm', 'o', 'j', 'i', ' ', '🤖' ]
[...'👩👩👧👦'] => [ '👩', '', '👩', '', '👧', '', '👦' ]
// Runes
runes('♥️') => ['♥️']
runes('Emoji 🤖') => ['E', 'm', 'o', 'j', 'i', ' ', '🤖']
runes('👩👩👧👦') => ['👩👩👧👦']核心函数分析
这个库主要导出两个工具函数,一个是 runes,用来替代原有的 split;另一个是 substr,用来正确地取出子串。
其实可以想到,最核心的肯定是 runes,当你能正确拆分一个字符串成为数组的时候,取子串无非就是把数组 splice 然后再 join 起来就行了。
所以我们主要分析下 runes 函数是怎么实现的:
function runes(string) {
  // 输入检查
  if (typeof string !== 'string') {
    throw new Error('string cannot be undefined or null')
  }

  const result = []
  let i = 0
  let increment = 0

  while (i < string.length) {
    // 确定当前字符由多少个代码单元组成
    increment += nextUnits(i + increment, string)

    // 一些特殊字符,例如罗马音标
    if (isGraphem(string[i + increment])) {
      increment++
    }
    // 如果是变体选择器,游标向后移动一位
    if (isVariationSelector(string[i + increment])) {
      increment++
    }
    // 如果是框之类的修饰符,游标向后移动一位
    if (isDiacriticalMark(string[i + increment])) {
      increment++
    }
    // 如果是零宽连接符,先不要 push 进去,再继续往后看
    if (isZeroWidthJoiner(string[i + increment])) {
      increment++
      continue
    }

    // 走到这就说明提取到了一个完整的字符
    result.push(string.substring(i, i + increment))
    i += increment
    increment = 0
  }

  return result
}
可以看到:
nextUnits函数决定当前字符由几个码元组成- 然后看连接符、修饰符
- 如果是变体选择器这类修饰符,就往后跳一位
- 如果是 ZWJ,说明得对后面的部分重新走一次该流程
再来看看 nextUnits 函数,该函数决定当前字符由多少个代码单元组成:
- 基本多文种平面(BMP)字符:1个代码单元
- 代理对表示的字符:2个代码单元
- 带肤色修饰符的emoji:4个代码单元
- 国旗emoji:4个代码单元
function nextUnits(i, string) {
  const current = string[i]

  // 如果不是代理对的首部或到达字符串末尾,则只取一个代码单元
  if (!isFirstOfSurrogatePair(current) || i === string.length - 1) {
    return 1
  }

  const currentPair = current + string[i + 1]
  let nextPair = string.substring(i + 2, i + 5)

  // 如果是国旗组合模式,那就是两个码点(四个码元)
  if (isRegionalIndicator(currentPair) && isRegionalIndicator(nextPair)) {
    return 4
  }

  // 肤色修饰符本身是一个非 BMP 的码点(所以要用 2 个码元表示),加上肤色就是 4 个码元
  if (isFitzpatrickModifier(nextPair)) {
    return 4
  }

  // 正常代理对
  return 2
}
解释一下里面的函数,因为很简短,就不贴代码了:
isFirstOfSurrogatePair其实就判断 current 是不是一个高代理对,如果不是,说明它是一个基本平面的字符,不需要特殊处理isRegionalIndicator其实就是判断当前代理对和下个代理对,是否都在国旗组合码点的范围内,即0x1f1e6到0x1f1ffisVariationSelector就是判断当前码元在不在0xfe00到0xfe0f范围内isZeroWidthJoiner就是判断当前码点是不是0x200DisFitzpatrickModifier判断是不是肤色选择器,其实就五个,0x1f3fb到0x1f3ff
4 总结
在这篇文章中,我们深入探究了emoji的工作原理及其在前端开发中的处理方法。首先了解了Unicode编码的基础概念,包括码点(Code Point)和码元(Code Unit),以及UTF-16编码如何通过代理对(Surrogate Pairs)表示超出基本平面的字符。
我们详细分析了几种常见的emoji组合模式:
- 基本的单码点emoji
- 带肤色修饰符的emoji
- 使用变体选择器显示为彩色的符号
- 国旗组合(由两个区域指示符组成)
- 使用零宽连接符(ZWJ)组合的复合emoji(如家庭、职业组合)
这些复杂的组合方式使得emoji表达更加丰富,但也给JavaScript字符串处理带来了挑战。由于JavaScript的字符串操作基于UTF-16码元而非Unicode字符,导致使用原生方法如String.split('')或.length处理含emoji字符串时出现问题。
最后,我们分析了runes.js库的源码实现。这个小巧的库通过理解Unicode编码规则和各种emoji组合模式,提供了runes()和substr()函数,能够正确处理包含复杂emoji的字符串分割和子串提取操作。其核心逻辑是识别各种Unicode字符的边界,确保emoji及其修饰符被视为单一的完整单元。
通过使用runes.js或理解其背后的原理,我们可以在前端开发中正确地显示、计算和操作含有emoji的字符串,避免出现乱码、长度计算错误等问题,从而提升用户体验。
5 函数 & 工具参考
查询 emoji 及其对应的码点:emojipedia
根据码点来查字符:Compart Unicode
根据码点查询字符:字嗨 zihi.com
获取 String 指定位置的码元:String.charCodeAt
获取 String 指定位置的码点:String.codePointAt
通过码点序列构造字符串: String.fromCodePoint
通过码元序列构造字符串: String.fromCharCode